
파이썬 정규표현식(re) 입문 - 패턴 매칭 기초부터 이메일·전화번호 추출까지 🔍
 글쓴이 Mojangcam
목차16개 항목
안녕하세요! Mojangcam입니다 😎
지난 편에서는 pandas로 엑셀 파일을 분석해봤어요. 표로 잘 정리된 데이터는 pandas가 최고인데요, 현실에서 만나는 데이터는 그렇게 착하지 않죠. 로그 파일, 게시글 본문, 크롤링해온 HTML처럼 줄줄이 이어진 텍스트 덩어리에서 원하는 것만 뽑아내야 할 때가 훨씬 많아요.
그럴 때 쓰는 게 바로 오늘의 주제, 정규표현식(Regular Expression, 줄여서 정규식) 입니다!
이번 편에서 배울 것
- 정규표현식이 뭐고 언제 쓰는지
re모듈 핵심 함수 5개 (search·findall·sub·split·compile)- 자주 쓰는 패턴 기호를 표로 한 번에 정리
- 이메일·전화번호·날짜 뽑아내기 실전 예제
- 로그 파일에서 에러만 골라내고 개인정보를 마스킹하는 완성 스크립트
"문자열에서 이메일만 골라내기", "주민번호 뒷자리 별표 처리하기", "로그에서 ERROR 줄만 뽑기" — 이런 작업을 if 'ERROR' in line 같은 걸로 억지로 처리하고 계셨다면, 오늘 글 하나로 확 편해지실 거예요 🙌
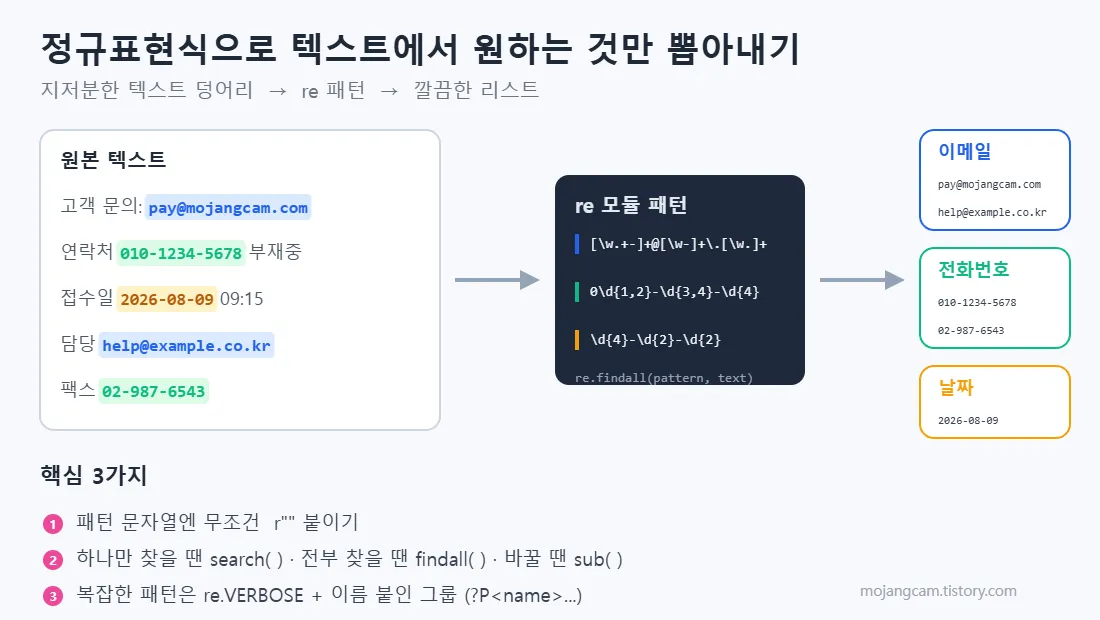
🧠 정규표현식이 왜 필요할까요?
예를 들어 이런 문자열에서 이메일 주소를 뽑는다고 해볼게요.
문의는 support@mojangcam.com 또는 help@example.co.kr 로 주세요정규식 없이 하려면 이렇게 되겠죠. 공백으로 자르고 → @가 들어있는 조각을 찾고 → 앞뒤 문장부호를 떼어내고… 이메일 형식이 조금만 달라져도 코드를 계속 고쳐야 해요.
정규식을 쓰면 이렇게 한 줄이에요.
import re

text = "문의는 support@mojangcam.com 또는 help@example.co.kr 로 주세요"
print(re.findall(r"[\w.+-]+@[\w-]+\.[\w.]+", text))
# ['support@mojangcam.com', 'help@example.co.kr']
정규식은 "내가 찾는 문자열의 생김새"를 규칙으로 적어두는 언어예요. 규칙만 정확히 적어두면 나머지는 파이썬이 알아서 다 찾아줍니다.
📌 준비물
- Python 3.8 이상 (예제는 3.8+에서 모두 동작해요)
re모듈 — 파이썬 표준 라이브러리라 설치가 필요 없어요!import re한 줄이면 끝이에요 😎- (선택) 패턴을 시각적으로 테스트해보고 싶다면 regex101.com 같은 온라인 테스터를 켜두면 편해요. 왼쪽 위에서 Python 모드로 바꾸는 걸 잊지 마세요.
💡 참고로 파이썬 3.11부터는 원자 그룹
(?>...)과 소유 수량자*+++?+가 추가돼서 성능이 중요한 패턴을 더 안전하게 쓸 수 있어요. 오늘 다루는 기본 문법은 3.8에서도 똑같이 동작하니 걱정 마세요.
📌 1단계 - 패턴 기호 익히기 (이 표만 알면 80%는 끝!)
정규식이 어려워 보이는 이유는 딱 하나, 기호가 낯설어서예요. 자주 쓰는 것만 모으면 생각보다 몇 개 안 됩니다.
| 기호 | 의미 | 예시 |
|---|---|---|
. |
아무 문자 1개 (줄바꿈 제외) | a.c → abc, a1c |
\d |
숫자 1개 (0~9) | \d\d → 42 |
\w |
글자·숫자·_ 1개 (한글도 포함!) |
\w+ → 안녕hello_1 |
\s |
공백·탭·줄바꿈 1개 | a\sb → "a b" |
[abc] |
대괄호 안 문자 중 1개 | [가-힣] → 한글 1글자 |
[^abc] |
대괄호 안 문자를 제외한 1개 | [^0-9] → 숫자 아닌 것 |
* |
앞 패턴 0번 이상 반복 | ab* → a, ab, abb |
+ |
앞 패턴 1번 이상 반복 | ab+ → ab, abb |
? |
앞 패턴 0번 또는 1번 | https? → http, https |
{2,4} |
앞 패턴 2~4번 반복 | \d{4} → 2026 |
^ / $ |
문자열의 시작 / 끝 | ^안녕 → "안녕"으로 시작 |
() |
그룹으로 묶어서 따로 꺼내기 | (\d{4})-(\d{2}) |
| ` | ` | 또는(OR) |
하나씩 뜯어볼게요 💡
\d{3,4}: 숫자가 3~4번 반복. 전화번호 국번(123또는1234)처럼 자릿수가 유동적일 때 딱이에요.+와*의 차이 :+는 최소 1번은 있어야 하고,*는 아예 없어도 통과예요. 대부분은+가 정답입니다.?의 두 가지 얼굴 : 단독으로 쓰면 "0~1번", 다른 반복 기호 뒤에 붙이면(*?,+?) "최소한만 매칭"하는 비탐욕(non-greedy) 모드가 돼요. HTML 태그 뽑을 때<.+?>처럼 자주 씁니다.
🧩 그리고 제일 중요한 것 — 무조건 r"" 로 감싸기!
pattern = r"\d{4}-\d{2}-\d{2}"   # ✅ 올바른 방법 (raw string)
pattern = "\d{4}-\d{2}-\d{2}" # ❌ 파이썬이 \d 를 이스케이프로 오해할 수 있어요r을 붙이면 파이썬이 백슬래시(\)를 문자 그대로 넘겨줘요. 정규식은 백슬래시를 밥 먹듯이 쓰기 때문에, 정규식 문자열 앞엔 무조건 r 붙이기를 습관으로 만드세요!
📌 2단계 - re 모듈 핵심 함수 5개
🧩 search() — 첫 번째로 걸리는 것 하나 찾기
import re

text = "주문번호는 ORD-20260809-0042 입니다"
m = re.search(r"ORD-\d{8}-\d{4}", text)

if m:
    print(m.group())   # ORD-20260809-0042
    print(m.start())   # 6  (찾은 위치)
else:
print("못 찾았어요")re.search(): 문자열 어디서든 찾아서 첫 번째 결과를 반환해요.m.group(): 실제로 매칭된 문자열을 꺼내요.- 못 찾으면
None을 반환하니,.group()을 부르기 전에if m:로 꼭 확인해주세요. (이거 안 하면 바로 아래 "자주 나는 에러" 1번을 만나게 돼요 😅)
비슷한 형제로 re.match() (문자열 맨 앞부터 일치하는지)와 re.fullmatch() (문자열 전체가 딱 맞는지)가 있어요. 입력값 검사엔 fullmatch가 제일 안전합니다.
🧩 findall() — 조건에 맞는 것 전부 리스트로
text = "고객센터 02-987-6543, 담당자 010-1234-5678, 팩스 031)111-2222"
phones = re.findall(r"0\d{1,2}[-)]\d{3,4}-\d{4}", text)
print(phones)
# ['02-987-6543', '010-1234-5678', '031)111-2222']
실무에서 제일 많이 쓰는 함수예요. 결과를 그냥 리스트로 주니까 바로 for문에 넣어 쓸 수 있죠.
⚠️ 단, 패턴에 괄호 그룹 ()이 있으면 그룹 부분만 리스트에 담긴다는 점을 주의하세요. 전체 문자열이 필요하면 그룹을 빼거나, re.finditer()를 쓰면 됩니다.
🧩 sub() — 찾아서 바꾸기 (마스킹의 핵심)
text = "신청자 홍길동 900101-1234567 접수완료"
masked = re.sub(r"(\d{6})-\d{7}", r"\1-*******", text)
print(masked)
# 신청자 홍길동 900101-******* 접수완료
re.sub(패턴, 바꿀문자열, 원본)순서예요.- 바꿀 문자열에서
\1은 "첫 번째 괄호 그룹에 잡힌 내용"이라는 뜻이에요. 앞 6자리는 살리고 뒷자리만 별표로 덮은 거죠. - 여기서도
r"\1-*******"처럼r붙이기를 잊지 마세요!
🧩 split() — 여러 구분자로 한 번에 쪼개기
text = "사과, 바나나  포도,딸기 / 참외"
print(re.split(r"[,/\s]+", text))
# ['사과', '바나나', '포도', '딸기', '참외']
파이썬 기본 .split()은 구분자를 하나밖에 못 넣죠. 쉼표·공백·슬래시가 뒤섞인 지저분한 데이터는 re.split() 한 방이면 정리됩니다.
🧩 compile() — 같은 패턴을 반복해서 쓸 때
EMAIL = re.compile(r"[\w.+-]+@[\w-]+\.[\w.]+")

for line in ["a@b.com 입니다", "연락처 없음", "c@d.co.kr"]:
    m = EMAIL.search(line)
    print(m.group() if m else "없음")
re.compile() 은 패턴을 미리 컴파일해서 객체로 만들어둬요. 반복문 안에서 수천 번 쓸 거라면 이게 훨씬 빠르고, 무엇보다 패턴을 파일 상단에 이름 붙여 모아둘 수 있어서 코드가 깔끔해집니다.
📌 3단계 - 이름 붙인 그룹으로 로그 파싱하기
괄호 그룹에 이름을 붙이면((?P<이름>...)) 결과를 딕셔너리처럼 꺼낼 수 있어요. 로그 파싱에 이만한 게 없습니다.
import re

LOG = re.compile(r"""
    (?P<date>\d{4}-\d{2}-\d{2})\s+     # 날짜
    (?P<time>\d{2}:\d{2}:\d{2})\s+     # 시각
    \[(?P<level>[A-Z]+)\]\s+           # 로그 레벨
    (?P<message>.+)                    # 메시지 전체
""", re.VERBOSE)

line = "2026-08-09 09:15:22 [ERROR] 결제 서버 응답 없음"
m = LOG.match(line)

print(m.group("level"))     # ERROR
print(m.group("message"))   # 결제 서버 응답 없음
print(m.groupdict())
# {'date': '2026-08-09', 'time': '09:15:22', 'level': 'ERROR', 'message': '결제 서버 응답 없음'}
하나씩 뜯어볼게요 💡
(?P<date>...): 그룹에date라는 이름표를 붙여요. 나중에m.group("date")로 꺼냅니다.m.group(1)처럼 번호로 세는 것보다 훨씬 안 헷갈려요.re.VERBOSE: 패턴 안의 공백과#주석을 무시해주는 플래그예요. 덕분에 위처럼 여러 줄로 예쁘게 쓰고 줄마다 설명을 달 수 있어요. 복잡한 패턴엔 거의 필수입니다!m.groupdict(): 이름 붙은 그룹을 통째로 딕셔너리로 반환해요. 그대로 JSON으로 저장하거나 pandas DataFrame에 넣기 딱 좋죠.
자주 쓰는 다른 플래그도 알아두세요.
re.IGNORECASE(re.I) : 대소문자 구분 안 함 →error도ERROR도 잡혀요.re.MULTILINE(re.M) :^,$가 줄마다 시작·끝을 의미하게 돼요.re.DOTALL(re.S) :.이 줄바꿈까지 포함하게 돼요.
📌 전체 코드 (복붙 OK)
로그 텍스트에서 에러만 뽑아내고, 개인정보는 마스킹하는 완성 스크립트예요. 그대로 복사해서 실행하면 바로 결과가 나옵니다!
# 파이썬 정규표현식(re) 실전 예제 / Python 3.8+
import re

SAMPLE_LOG = """
2026-08-09 09:15:22 [INFO] 서버 시작 완료
2026-08-09 09:16:03 [ERROR] 결제 서버 응답 없음 (문의: pay@mojangcam.com)
2026-08-09 09:17:41 [WARNING] 응답 지연 1200ms
2026-08-09 09:20:10 [ERROR] 회원 조회 실패 - 연락처 010-1234-5678
2026-08-09 09:22:00 [INFO] 배치 작업 종료
"""

LOG_PATTERN = re.compile(r"""
    (?P<date>\d{4}-\d{2}-\d{2})\s+
    (?P<time>\d{2}:\d{2}:\d{2})\s+
    \[(?P<level>[A-Z]+)\]\s+
    (?P<message>.+)
""", re.VERBOSE)

EMAIL_PATTERN = re.compile(r"[\w.+-]+@[\w-]+\.[\w.]+")
PHONE_PATTERN = re.compile(r"0\d{1,2}-\d{3,4}-\d{4}")

def parse_log(raw_text):
    rows = []
    for line in raw_text.strip().splitlines():
        m = LOG_PATTERN.match(line.strip())
        if m:
            rows.append(m.groupdict())
    return rows

def mask_privacy(text):
    text = EMAIL_PATTERN.sub(lambda m: m.group()[0] + "***@" + m.group().split("@")[1], text)
    text = PHONE_PATTERN.sub(lambda m: m.group()[:-4] + "****", text)
    return text

def main():
    logs = parse_log(SAMPLE_LOG)
    print(f"총 {len(logs)}줄 파싱 완료\n")
    counts = {}
    for row in logs:
        counts[row["level"]] = counts.get(row["level"], 0) + 1
    print("레벨별 개수:", counts)
    print("\n--- ERROR 목록 (개인정보 마스킹) ---")
    for row in logs:
        if row["level"] == "ERROR":
            safe_msg = mask_privacy(row["message"])
            print(f"[{row['time']}] {safe_msg}")
    print("\n--- 발견된 연락처 ---")
    print("이메일:", EMAIL_PATTERN.findall(SAMPLE_LOG))
    print("전화번호:", PHONE_PATTERN.findall(SAMPLE_LOG))

if __name__ == "__main__":
    main()
📌 실행 결과
총 5줄 파싱 완료

레벨별 개수: {'INFO': 2, 'ERROR': 2, 'WARNING': 1}

--- ERROR 목록 (개인정보 마스킹) ---
[09:16:03] 결제 서버 응답 없음 (문의: p***@mojangcam.com)
[09:20:10] 회원 조회 실패 - 연락처 010-1234-****

--- 발견된 연락처 ---
이메일: ['pay@mojangcam.com']
전화번호: ['010-1234-5678']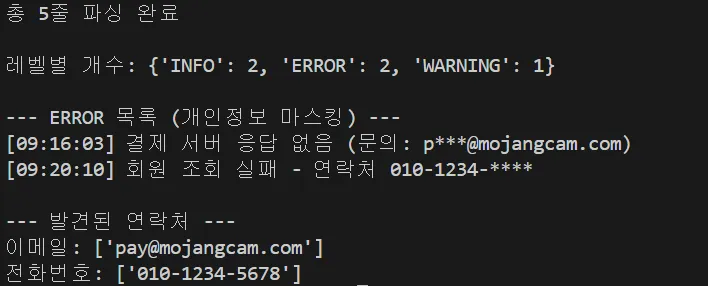
로그 몇 줄짜리 예제지만, SAMPLE_LOG를 open("app.log", encoding="utf-8").read() 로만 바꾸면 수만 줄짜리 실제 로그 파일에도 그대로 통해요. 결과를 pandas DataFrame에 넣으면 시간대별 에러 추이 분석까지 이어집니다 💡
📌 자주 나는 에러
1. AttributeError: 'NoneType' object has no attribute 'group'
- 원인 :
re.search()가 아무것도 못 찾아서None을 반환했는데, 거기다.group()을 불렀을 때 나요. 정규식 입문자가 가장 많이 만나는 에러입니다. - 해결 : 반드시 결과를 먼저 확인하세요.
m = re.search(pattern, text)
if m:
    print(m.group())
else:
    print("매칭되는 내용이 없어요")
2. re.error: bad escape \d at position 0
- 원인 : 패턴 문자열에
r을 안 붙여서 파이썬이\d를 문자열 이스케이프로 먼저 해석해버린 경우예요. - 해결 :
re.compile("\d+")→re.compile(r"\d+")로 바꿔주세요. 정규식엔 무조건r!
3. re.error: nothing to repeat at position 0
- 원인 :
*,+,?같은 반복 기호 앞에 반복할 대상이 없을 때예요.+82처럼+를 진짜 플러스 문자로 쓰려던 경우가 대부분이에요. - 해결 : 특수문자를 문자 그대로 쓰려면 백슬래시로 이스케이프하세요.
r"\+82"처럼요. 변수에 담긴 값을 패턴에 넣을 땐re.escape(값)을 쓰면 안전합니다.
4. 원하는 것보다 너무 많이 잡혀요 (탐욕 매칭)
- 원인 :
.+는 기본이 탐욕(greedy) 이라 가능한 한 길게 먹어요.<b>안녕</b><b>반가워</b>에<.+>를 쓰면 전체가 통째로 잡힙니다. - 해결 : 뒤에
?를 붙여 비탐욕으로 바꾸세요.<.+?>로 하면 태그 하나씩 잘 잡혀요.
5. 한글이 안 잡혀요
- 원인 :
[a-zA-Z]같은 영문 전용 문자 클래스를 썼기 때문이에요. - 해결 : 한글은
[가-힣]로 잡으면 됩니다. 참고로 파이썬 3의\w는 기본이 유니코드 모드라 한글도 이미 포함돼요.\w+로도 잘 잡힙니다.
💬 마무리
오늘은 파이썬 정규표현식의 기초를 훑어봤어요. 정리하면 이렇습니다.
- 패턴 문자열엔 무조건
r""를 붙인다 - 하나 찾을 땐
search, 다 찾을 땐findall, 바꿀 땐sub - 복잡한 패턴은
re.VERBOSE+ 이름 붙인 그룹(?P<name>...)으로 읽기 좋게 - 반복해서 쓸 패턴은 파일 상단에
re.compile로 모아두기
기호가 낯설어서 그렇지, 오늘 표에 있는 열몇 개만 손에 익으면 실무의 대부분은 커버돼요. 처음엔 regex101.com 같은 테스터에 붙여넣고 초록불 켜지는 걸 확인하면서 익히는 게 제일 빠릅니다 🙌
다음 편에서는 오늘 배운 정규식을 실제로 써먹어볼 차례예요. 파이썬 웹 크롤링 실전 - 뉴스 수집 자동화 편에서 크롤링해온 지저분한 텍스트를 정규식으로 깔끔하게 정리하는 걸 보여드릴게요. 기대해주세요! 🙌
📚 함께 보면 좋은 글
