
파이썬 코드 실행 속도 올리는 법 5가지 - 내 코드는 왜 느릴까? ⚡
 글쓴이 Mojangcam
목차11개 항목
안녕하세요! Mojangcam입니다 😎
파이썬으로 이것저것 만들다 보면 어느 순간 이런 생각이 들어요. "어? 내 코드… 왜 이렇게 느리지?" 분명 똑같은 일을 하는 코드인데, 쓰는 방식에 따라 실행 속도가 몇 배에서 많게는 만 배 넘게 차이 날 수 있다는 사실, 알고 계셨나요?
오늘은 코드 한두 줄만 바꿔도 바로 효과가 보이는 파이썬 속도 최적화 방법 5가지를 직접 잰 실측 결과와 함께 정리해볼게요. 어려운 C 확장이나 외부 라이브러리 없이 파이썬 기본기만으로 되는 것들만 골랐으니, 입문자분들도 부담 없이 따라오시면 됩니다!
📌 준비물
- Python 3.8 이상 (권장: 3.11 이상 — 이유는 방법 5에서 알려드릴게요!)
- 설치할 라이브러리 없음 — 오늘은 전부 표준 라이브러리(timeit, functools)만 사용해요
- 참고로 글 작성 시점(2026-08) 기준 최신 안정 버전은 Python 3.14.7입니다
🧠 시작 전에 - 최적화 제1원칙, "느낌으로 하지 말고 재보기"
"이 코드 느린 것 같은데?"라는 감으로 최적화를 시작하면 엉뚱한 곳만 고치다 끝나기 쉬워요. 그래서 최적화의 시작은 언제나 측정입니다. 파이썬에는 짧은 코드의 실행 시간을 재주는 timeit이 기본으로 들어있어요.
import timeit

# 함수(람다)를 넘기면 지정한 횟수만큼 실행하고, 총 걸린 시간을 초 단위로 돌려줘요
result = timeit.timeit(lambda: sum(range(100_000)), number=100)
print(f"100번 실행에 {result:.4f}초")
하나씩 뜯어볼게요 💡
- timeit : 짧은 코드 조각의 실행 시간을 정밀하게 재는 표준 라이브러리예요. 설치 없이 바로 import 가능!
- number : 같은 코드를 몇 번 반복해서 잴지 정하는 파라미터예요. 한 번만 재면 오차가 크기 때문에 여러 번 돌린 총합으로 비교합니다.
- 프로그램이 커서 "어디가" 느린지부터 찾아야 한다면 cProfile(
python -m cProfile my_script.py)로 함수별 소요 시간을 확인할 수 있어요.
이제 본격적으로 5가지 방법을 하나씩 볼게요!
📌 방법 1 - "있나 없나" 검사는 list 말고 set으로!
오늘 소개할 것 중 효과가 가장 극적인 방법이에요. in 연산자로 값이 있는지 검사할 때, list는 앞에서부터 하나씩 전부 확인하지만 set은 해시(hash)로 위치를 바로 계산해서 찾아요. 데이터가 많을수록 차이가 어마어마해집니다.
N = 100_000
data_list = list(range(N))
data_set = set(data_list)   # list를 set으로 변환

# 10만 개 중에서 맨 끝에 있는 값을 찾는 최악의 경우
print(99_999 in data_list)  # 느려요 (하나씩 다 확인)
print(99_999 in data_set)   # 빨라요 (해시로 바로 점프)
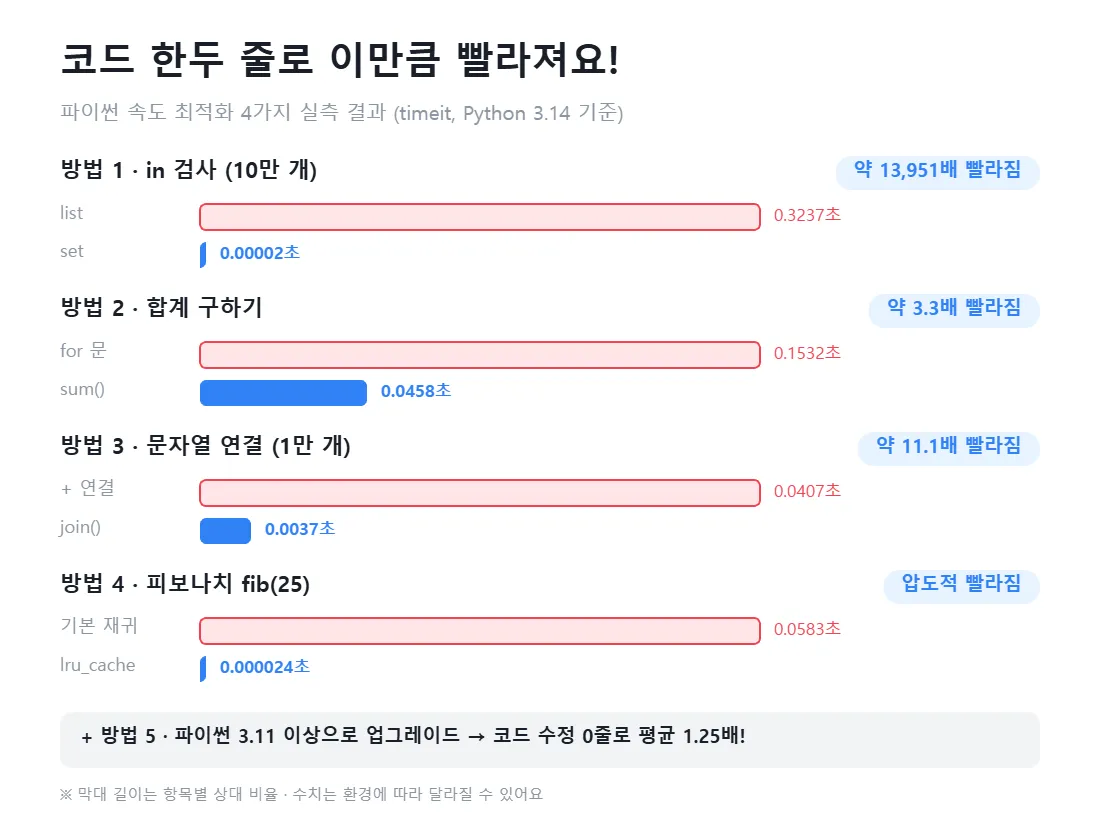
제 환경에서 1,000번 반복 측정한 결과, list는 0.3237초, set은 0.00002초. 무려 약 14,000배 차이가 났어요! 금지어 필터, 아이디 중복 체크처럼 in 검사를 반복하는 코드라면 컬렉션을 set(또는 dict)으로 바꾸는 것만으로 체감이 확 달라집니다.
📌 방법 2 - for 누적 대신 내장 함수·컴프리헨션
파이썬의 내장 함수(sum, max, min 등)와 리스트 컴프리헨션은 내부가 C로 구현되어 있어서, 같은 반복이라도 순수 파이썬 for 문보다 빨라요.
N = 100_000

# 느린 버전: for 문으로 직접 누적
total = 0
for i in range(N):
    total += i

# 빠른 버전: 내장 함수 sum
total = sum(range(N))

# 리스트를 만들 때도 마찬가지예요
squares = []
for i in range(N):        # 느린 버전
    squares.append(i * i)

squares = [i * i for i in range(N)]  # 빠른 버전 (컴프리헨션)
측정해보니 합계 구하기는 for 문 0.153초 vs sum 0.046초로 약 3.3배 차이. 코드도 짧아지고 속도도 빨라지니 일석이조죠!
📌 방법 3 - 문자열 이어 붙이기는 + 말고 join
파이썬의 문자열은 불변(immutable)이라, s += word를 할 때마다 새 문자열을 통째로 만들어요. 반복문 안에서 +=로 문자열을 쌓고 있다면 join으로 바꿔보세요.
words = ["파이썬"] * 10_000

# 느린 버전: 매번 새 문자열 생성
s = ""
for w in words:
    s += w

# 빠른 버전: 한 번에 합치기
s = "".join(words)
하나씩 뜯어볼게요 💡
- "".join(리스트) : 구분자(여기서는 빈 문자열)로 리스트 안 문자열들을 한 번에 이어 붙여요. 중간 결과물을 안 만들어서 빠릅니다.
- 쉼표로 구분하고 싶다면
", ".join(words)처럼 구분자만 바꾸면 돼요.
제 측정으로는 + 방식 0.0407초 vs join 0.0037초, 약 11.1배 차이였어요.
📌 방법 4 - 같은 계산을 또 하고 있다면? lru_cache 한 줄 캐싱
같은 입력으로 같은 함수를 반복 호출하는 코드라면, functools.lru_cache 데코레이터 한 줄로 결과를 저장(캐싱)해서 재사용할 수 있어요. 대표 예제인 재귀 피보나치로 볼게요.
import functools

# 느린 버전: 같은 계산을 수없이 반복
def fib(n):
    return n if n < 2 else fib(n - 1) + fib(n - 2)

# 빠른 버전: 데코레이터 한 줄 추가
@functools.lru_cache(maxsize=None)
def fib_cached(n):
    return n if n < 2 else fib_cached(n - 1) + fib_cached(n - 2)
하나씩 뜯어볼게요 💡
- @functools.lru_cache : 함수의 (인자 → 결과)를 딕셔너리처럼 저장해두고, 같은 인자로 다시 부르면 계산 없이 저장된 값을 바로 돌려줘요.
- maxsize : 캐시에 몇 개까지 저장할지 정해요.
None이면 무제한, 숫자를 주면 가장 오래 안 쓴 것부터 버립니다(LRU = Least Recently Used).
fib(25)를 10번 호출해보니 기본 버전 0.0583초 vs 캐싱 버전 0.000024초. 두 번째 호출부터는 저장된 값을 꺼내기만 하니 사실상 비교가 안 되는 수준이에요. API 응답 가공, 설정 파일 파싱처럼 "입력이 같으면 결과도 같은" 함수에 특히 잘 맞습니다.
📌 방법 5 - 파이썬 버전만 올려도 빨라져요
코드를 한 줄도 안 고치고 빨라지는 방법도 있어요. 바로 파이썬 버전 업그레이드입니다.
- Python 3.11: 공식 문서 기준 3.10 대비 평균 1.25배(작업에 따라 10
60%) 빨라졌어요. 아직 3.83.10을 쓰신다면 이것만으로도 무료 성능 업그레이드! - Python 3.14: 새 인터프리터(tail-call interpreter) 도입으로 공식 벤치마크 기준 3~5% 추가 개선(빌드 환경에 따라 달라요). 현재 최신 안정 버전은 3.14.7(2026-08-05 릴리스)입니다.
- 차기 버전 3.15도 rc(출시 후보) 버전이 나온 상태라, 파이썬은 매년 꾸준히 빨라지는 중이에요.
💬 단, 실제 프로젝트에서는 쓰는 라이브러리가 새 버전을 지원하는지 먼저 확인하고 올리는 게 안전해요!
📌 전체 코드 (복붙 OK)
위 방법 1~4를 한 번에 측정하는 벤치마크 스크립트예요. 그대로 복사해서 speed_test.py로 저장하고 실행해보세요!
# speed_test.py - Python 3.8+ (권장: 3.11 이상)
import timeit
import functools
import sys

N = 100_000

# 1. list vs set 멤버십 검사
data_list = list(range(N))
data_set = set(data_list)
t_list = timeit.timeit(lambda: 99_999 in data_list, number=1_000)
t_set = timeit.timeit(lambda: 99_999 in data_set, number=1_000)

# 2. for 누적 vs 내장 함수 sum
def loop_sum():
    total = 0
    for i in range(N):
        total += i
    return total

t_loop = timeit.timeit(loop_sum, number=100)
t_sum = timeit.timeit(lambda: sum(range(N)), number=100)

# 3. 문자열 + 연결 vs join
words = ["파이썬"] * 10_000

def concat_plus():
    s = ""
    for w in words:
        s += w
    return s

t_plus = timeit.timeit(concat_plus, number=100)
t_join = timeit.timeit(lambda: "".join(words), number=100)

# 4. 재귀 피보나치 vs lru_cache 캐싱
def fib(n):
    return n if n < 2 else fib(n - 1) + fib(n - 2)

@functools.lru_cache(maxsize=None)
def fib_cached(n):
    return n if n < 2 else fib_cached(n - 1) + fib_cached(n - 2)

t_fib = timeit.timeit(lambda: fib(25), number=10)
t_fib_cached = timeit.timeit(lambda: fib_cached(25), number=10)

print(f"Python {sys.version.split()[0]} 기준\n")
print(f"1. in 검사      : list {t_list:.4f}초 vs set {t_set:.5f}초 → 약 {t_list/t_set:,.0f}배 차이")
print(f"2. 합계 구하기  : for {t_loop:.4f}초 vs sum {t_sum:.4f}초 → 약 {t_loop/t_sum:.1f}배 차이")
print(f"3. 문자열 연결  : +  {t_plus:.4f}초 vs join {t_join:.4f}초 → 약 {t_plus/t_join:.1f}배 차이")
print(f"4. 피보나치(25) : 기본 {t_fib:.4f}초 vs 캐싱 {t_fib_cached:.6f}초 → 비교 불가 수준!")
📌 실행 결과
제 컴퓨터(Python 3.14 환경)에서 실행한 결과예요. 수치는 컴퓨터 사양에 따라 다르지만, 배수 차이의 경향은 어디서든 비슷하게 나옵니다.
Python 3.14.5 기준

1. in 검사      : list 0.3237초 vs set 0.00002초 → 약 13,951배 차이
2. 합계 구하기  : for 0.1532초 vs sum 0.0458초 → 약 3.3배 차이
3. 문자열 연결  : +  0.0407초 vs join 0.0037초 → 약 11.1배 차이
4. 피보나치(25) : 기본 0.0583초 vs 캐싱 0.000024초 → 비교 불가 수준!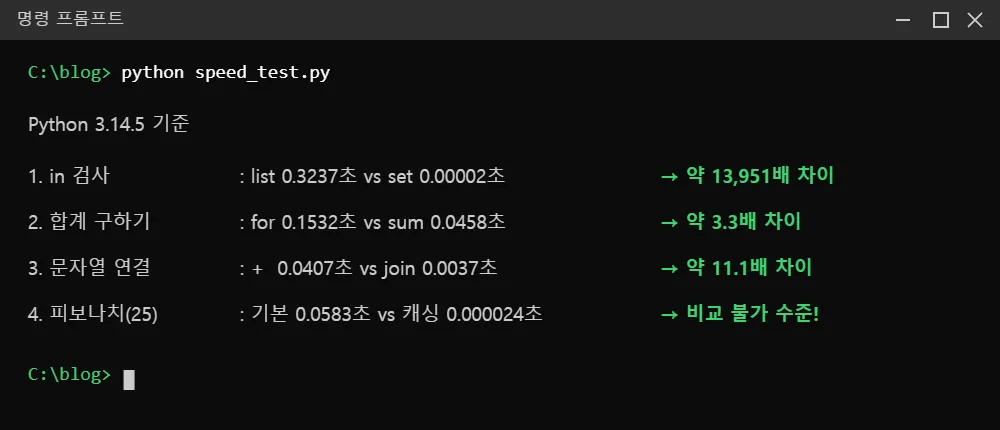
같은 일을 하는 코드인데 이렇게까지 차이 나는 게 신기하지 않나요? 😄
📌 자주 나는 에러·주의점
- NameError: name 'data_list' is not defined
- 원인:
timeit.timeit("99999 in data_list", number=1000)처럼 코드를 문자열로 넘기면, timeit이 별도의 네임스페이스에서 실행해서 내 변수를 못 찾아요. - 해결: 이 글처럼 람다로 감쎌서 넘기거나,
timeit.timeit("...", globals=globals())로 현재 변수들을 전달하면 됩니다.
- 원인:
- TypeError: unhashable type: 'list'
- 원인:
lru_cache는 인자를 딕셔너리 키로 저장하는데, 리스트는 키가 될 수 없어요(해시 불가). - 해결: 인자를 튜플로 바꿔서 넘기세요. 예:
my_func(tuple(my_list))
- 원인:
- (주의) 섣부른 최적화는 금물!
- 잘 돌아가는 코드를 전부 뜯어고칠 필요는 없어요. 측정으로 병목을 찾고, 그 부분만 고치는 게 좋은 최적화입니다. 읽기 좋은 코드가 우선이에요.
📌 마무리
오늘은 파이썬 코드 실행 속도를 올리는 5가지 방법을 알아봤어요!
in검사는 list 대신 set (최대 1만 배 이상)- for 누적 대신 내장 함수·컴프리헨션 (약 3배)
- 문자열 연결은
+대신 join (약 5배) - 반복 계산은 lru_cache 한 줄 캐싱 (압도적)
- 파이썬 버전 업그레이드 (3.11에서 평균 1.25배)
다섯 가지 모두 오늘 바로 여러분 코드에 적용할 수 있는 것들이니, 벤치마크 스크립트로 직접 차이를 확인해보세요! 그리고 내일은 완전히 새로운 도전, 언리얼 엔진 5(UE5) 입문기 시리즈 1편으로 찾아올 예정이에요. 게임 개발에 관심 있으셨다면 기대해주세요 🙌
그럼 다음 글에서 만나요!
