
分类: Python
Python 3.15 正式版倒计时 13 天!提前检查你的代码会不会出问题 - 默认 UTF-8(告别 cp949)·lazy import 迁移检查清单 🐍
 作者 Mojangcam
本文译自韩语原文。
目录12 项
大家好!我是 Mojangcam 😎
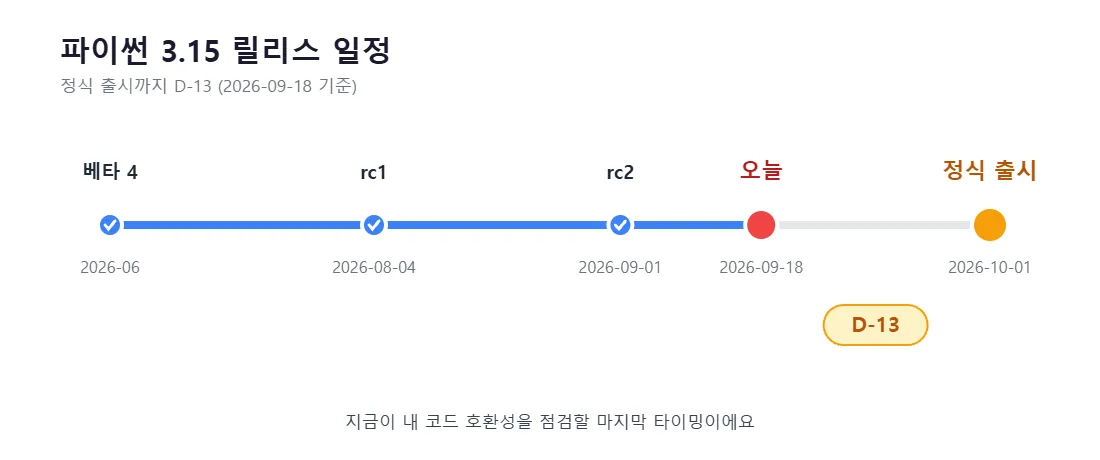
终于,Python 3.15 正式版将于 2026 年 10 月 1 日发布。今天是 9 月 18 日,正好是 D-13(倒计时 13 天)。
到目前为止,这个博客已经写了 3.15 的 beta 4、rc1、rc2 三篇,主要讲的是"有哪些新东西"。今天换个方向。不是来看新功能,而是来检查 "我现在用的代码到了 3.15 会不会出问题?"
这次的 3.15 对在韩国使用 Python 的人来说是个特别大的变化。那个臭名昭著的 cp949 编码地狱终于要结束了。不过结束的同时,那些一直依赖 cp949 运行的代码反而可能出问题。😅
📌 准备工作
- Python 3.15.0rc2(2026-09-01 发布,正式版前的最后一个 rc)
- 之前一直在用的 Python 3.13 或 3.14(最好一起装上,方便对比)
- 几个测试用的文本文件(最好有一个以 cp949 保存的韩文文件)
- 顺手的编辑器(推荐 VS Code)
目的是在正式版之前先跑一遍,所以现有版本不要卸载,另外单独安装。Windows 安装时会一起装上 py 启动器,所以可以用 py -3.15 脚本.py 来选择版本运行。
# 查看已安装的 Python 版本(Windows)
py --list

# 用 3.15 运行
py -3.15 test.py

# macOS/Linux
python3.15 test.py
🧠 为什么现在就要检查?
很多人会想"等正式版出来再说吧"。但这次有点不一样。
3.15 的 PEP 686 改变的是打开文件这件事本身的默认值。可怕的地方在于,它可能不报错,而是悄悄地出问题。程序跑得好好的,CSV 里的韩文却变成了 ?????,或者打开日志文件一看全是乱码。
尤其是每天自动运行的脚本(Excel 自动化、爬虫、自动发邮件之类),因为没人每次都去看结果,往往要过好几天才发现。所以需要提前检查。
🧩 变化 1 - 现在文件一律以 UTF-8 打开 (PEP 686)
先来看最重要的变化。
到 3.14 为止,open() 不写 encoding 的话,用的是操作系统的区域设置(locale)编码。在韩文 Windows 上就是 cp949(euc-kr 系),在 macOS·Linux 上则是 UTF-8。所以才会出现那个有名的现象:同样的代码在 Windows 上乱码,在 Mac 上却好好的。
从 3.15 开始,不管什么操作系统,一律是 UTF-8。
# Python 3.15 / 不写编码会怎样?

with open("메모.txt") as f:      # 3.14 及以下(Windows)→ cp949
    print(f.read())               # 3.15 → UTF-8(与 OS 无关)
逐个拆开来看 💡
- open() 的默认 encoding:从 3.15 开始固定为 UTF-8。即使不去动 PYTHONUTF8 之类的环境变量也是如此。
- subprocess(text=True):这边也一样以 UTF-8 为准运行。
- encoding="locale":如果想像以前一样明确指定"跟随 OS 的区域设置",就用这个特殊值。
- locale.getencoding():想直接查出当前 OS 区域设置编码是什么时用的函数。
🛠️ 30 秒确认你的代码有没有风险
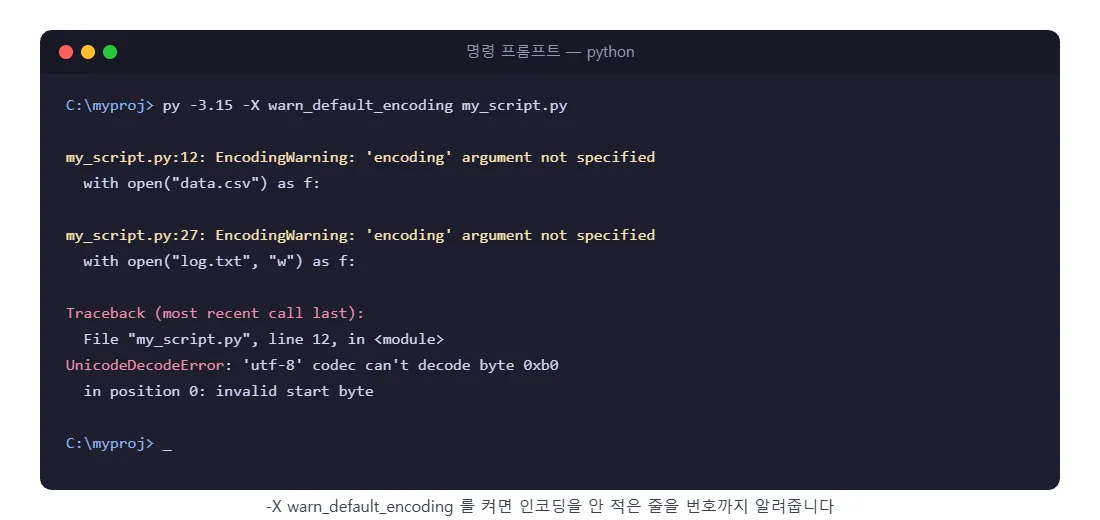
最快的方法是找出所有省略了编码的 open()。Python 本来就有专门做这件事的警告选项。
# 对依赖默认编码的代码发出警告
py -3.15 -X warn_default_encoding my_script.py
这样运行的话,会出现 EncodingWarning,并告诉你是第几行有问题。被抓出来的这些行,就是在 3.15 中行为可能改变的候选。
🛠️ 修改方法三选一
① 最推荐 - 直接写明编码
# 今后新建的文件:统一用 UTF-8
with open("result.txt", "w", encoding="utf-8") as f:
    f.write("你好")

# 读取以前用 cp949 保存的文件时
with open("old_data.csv", encoding="cp949") as f:
print(f.read())这是最稳妥的。因为不管什么版本,行为都一样。把编码永远写上变成习惯,才是正确答案。
② 如果想保持以前的行为
# 明确指定"跟随 OS 区域设置"(韩文 Windows 下就是 cp949)
with open("legacy.txt", encoding="locale") as f:
    print(f.read())
③ 着急的话整体恢复(权宜之计)
# 用环境变量关闭 UTF-8 模式
set PYTHONUTF8=0        # Windows CMD

# 或者用运行选项
py -3.15 -X utf8=0 my_script.py③只是权宜之计。Python 走向 UTF-8 的趋势不会回头,所以先争取点时间,最终还是应该按①来改。
💡 Excel 韩文乱码是另一回事
这是自动化题材里经常出现的情况。用 UTF-8 保存了 CSV,在 Excel 里打开时韩文却乱码的问题,和 3.15 无关,是以前就有的另一个问题。因为 Excel 不太能识别不带 BOM 的 UTF-8。
import csv

# 如果是要在 Excel 里双击打开的 CSV,就用 utf-8-sig
with open("보고서.csv", "w", encoding="utf-8-sig", newline="") as f:
    w = csv.writer(f)
    w.writerow(["姓名", "部门", "分数"])
w.writerow(["张三", "销售", 92])utf-8-sig:本质是 UTF-8,但会在文件最前面加上 BOM 标记的编码。Excel 看到这个标记就会知道"哦,是 UTF-8"。
🧩 变化 2 - lazy import,现在真的能用了 (PEP 810)
第二个是显式延迟导入。它在 rc 阶段已经确定,会原样进入正式版。
# Python 3.15+
lazy import json
lazy from pathlib import Path
加了 lazy 的导入,在真正用到那个名字之前不会加载模块。 如果你的脚本在最上面写了一大堆重量级库,实际上只在特定命令里才用到,启动速度会明显变快。
逐个拆开来看 💡
- lazy:不是保留字,而是软关键字。所以以前用 lazy 当变量名的代码不会出问题。
- 只能在模块顶层使用:在函数里、类里、try/except/finally 里使用会报 SyntaxError。
- 不支持的组合:lazy from module import * 和 lazy from __future__ import ... 都不行。
- sys.lazy_modules:被延迟的模块名会登记在这里,而不是 sys.modules。
- -X lazy_imports=all:不改源代码就把所有导入都延迟的运行选项。相反,normal(默认值)只认 lazy 关键字。
⚠️ 这里要注意
用了 lazy import,导入失败会延后才爆出来。 原本程序一启动就会用 ModuleNotFoundError 告诉你,现在要等到第一次用到那个模块时才报错。
如果是像 24 小时运行的 Discord 机器人那样半夜悄悄挂掉会很麻烦的程序,建议少用延迟导入,并同时做好错误处理和日志。(相关文章:《Python 办公自动化 #13 - 搭建日志·重试·失败通知体系》、《Discord 机器人开发 #25 - 搭建错误处理·日志体系》)
还有一点,要记住这是只有 3.15 才支持的语法。在需要跑在 3.14 及以下版本的代码里写 lazy,直接就是语法错误。如果两个版本都要支持,可以用 __lazy_modules__ 这个办法。
# 在 3.15 中延迟加载,在更低版本中直接被忽略的方式
__lazy_modules__ = ["json", "pathlib"]

import json      # 在 3.15 中以 lazy 方式运行
📌 迁移检查清单(可直接复制)
在正式版之前,按这个顺序各跑一遍就行。
# 1) 安装 3.15rc2 后确认与现有版本共存
py --list

# 2) 找出所有依赖默认编码的代码
py -3.15 -X warn_default_encoding my_script.py

# 3) 如果有测试,打开警告后全部运行
py -3.15 -X warn_default_encoding -m pytest

# 4) 确认主要库是否支持 3.15
py -3.15 -m pip install -r requirements.txt
然后用眼睛逐项检查下面这些。
- open() 里还有没写 encoding= 的地方吗?
- 有读取过去以 cp949 保存的文件的代码吗?→ 明确写上 encoding="cp949"
- 会生成要用 Excel 打开的 CSV 吗?→ encoding="utf-8-sig"
- 用 subprocess.run(..., text=True) 接收 Windows 命令的输出吗?→ 确认韩文输出有没有乱码
- requirements.txt 里的库都发布了 3.15 的 wheel 吗?(带 C 扩展的包对新版本的支持可能会慢一些)
- 部署服务器·GitHub Actions 的 Python 版本什么时候升级,定好了吗?
📌 常见错误
1. UnicodeDecodeError: 'utf-8' codec can't decode byte 0xb0 in position 0
- 原因:3.15 想用 UTF-8 读取,但那个文件其实是以 cp949 保存的韩文文件。这是在 3.14 上好好的代码到了 3.15 才第一次报错的典型情况。
- 解决:明确写成 open(路径, encoding="cp949")。把文件本身重新保存为 UTF-8 会更干净。
2. UnicodeDecodeError: 'cp949' codec can't decode byte ...
- 原因:和上面正好相反。是在 3.14 及以下的 Windows 上不指定编码打开 UTF-8 文件的情况。
- 解决:明确写上 encoding="utf-8"。如果这个错误经常出现,光是升级到 3.15 就能让其中大部分消失。
3. SyntaxError: lazy import is only allowed at module level
- 原因:在函数里或 try 块里用了 lazy。
- 解决:移到文件顶层。如果需要按条件加载,就像以前一样在函数里用普通 import。
4. 程序运行正常,但结果文件里只有韩文是乱码(没有报错)
- 原因:读和写的编码不一致,但没有抛出异常。这是最难发现的类型。
- 解决:读和写两边都明确写上编码,再用 -X warn_default_encoding 扫一遍有没有遗漏的地方。
5. ERROR: Could not build wheels for ...(安装 3.15 时)
- 原因:该库还没有发布 3.15 的构建。正式版发布后的几周内很常见。
- 解决:不急的话就等一等。工作用的环境不要正式版一出就升级,等主要依赖都发布了 3.15 的 wheel 之后再迁移更安全。
📌 总结
今天的内容总结一下 🙌
- 10 月 1 日 Python 3.15 正式版发布。以今天为准 D-13
- PEP 686:open() 的默认编码与 OS 无关,统一为 UTF-8 → 对韩国 Windows 用户来说是最大的变化
- 想恢复原来的行为可以用 encoding="locale"、PYTHONUTF8=0、-X utf8=0 — 不过只是权宜之计
- PEP 810:用 lazy import 提升启动速度。但只能在模块顶层使用,而且是 3.15 专用语法
- 现在要做的只有一件事 — 用 -X warn_default_encoding 找出没写编码的地方并补上
下一篇打算讲配合正式版发布,实际迁移到 3.15 的过程。包括新建虚拟环境、确认库的兼容性,以及把自动化脚本不停机迁移过去的步骤。敬请期待!💬
📚 相关文章
- Python 3.15 新功能整理 - lazy import·frozendict·默认 UTF-8(基于 beta 4)
- Python 3.15 rc1 发布!lazy import 正式确定 - 与 beta 4 相比的变化总结
- Python 3.15 rc2 发布!正式版(10/1)前的最后检查 - 与 rc1 相比的变化总结
- Python 3.15 正式版 D-13 迁移检查清单 ← 就是这篇!
- Python 虚拟环境(venv)完全指南 - 从创建到激活·删除
