
디스코드 봇 만들기#17RAG로 문서 기반 답변봇 만들기! 우리 서버 전용 FAQ 봇 (파이썬 예제)
 글쓴이 Mojangcam
목차15개 항목
안녕하세요! Mojangcam입니다 😎
지난 #16편에서는 봇이 정해진 시간에 먼저 말을 거는 리마인더·알림 기능을 만들어봤어요.
오늘은 한 단계 더 나아가서, 우리 서버 문서를 읽고 대답하는 봇을 만들어볼게요. 이런 걸 RAG(검색 증강 생성, Retrieval-Augmented Generation) 라고 불러요!
서버를 운영하다 보면 이런 질문이 매일 반복되죠.
- "서버 규칙 어디서 봐요?"
- "모드 설치 방법 좀요"
- "신청 양식 어떻게 써요?"
공지에 다 적어놨는데도 물어봐요 😂 이걸 봇이 대신 답해주면 어떨까요? 그것도 아무 말이나 지어내지 않고, 우리가 준 문서만 보고 말이죠. 오늘 그 봇을 만들어봅니다!
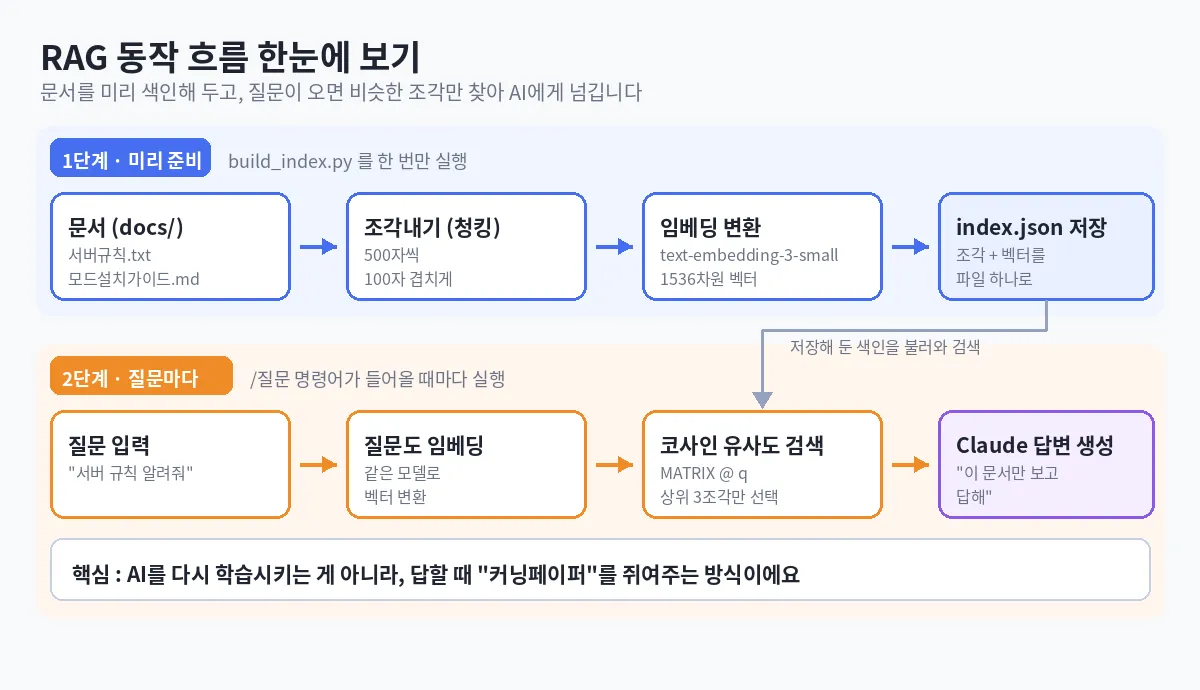
🧠 RAG가 뭔가요? (그냥 AI 붙이면 안 되나요?)
#9편에서 Claude·ChatGPT API를 봇에 붙여봤어요. 그런데 그 봇한테 "우리 서버 규칙 알려줘"라고 물으면 어떻게 될까요? 모릅니다. 우리 서버 공지는 AI가 배운 적이 없으니까요. 심하면 그럴듯하게 지어냅니다(환각, Hallucination).
RAG는 이 문제를 아주 단순한 방법으로 풀어요.
- 미리 우리 문서를 잘게 쪼개서 저장해둡니다
- 질문이 오면 그 질문과 가장 비슷한 조각 몇 개만 찾습니다
- 그 조각을 AI에게 같이 넘기면서 "이것만 보고 답해"라고 시킵니다
즉 AI를 다시 학습시키는 게 아니라, 답할 때 커닝페이퍼를 쥐여주는 것이에요. 그래서 좋은 점이 많아요.
| 장점 | 설명 |
|---|---|
| 파인튜닝 불필요 | 모델을 다시 학습시킬 필요 없이, 문서 파일만 바꾸면 끝이에요 |
| 출처 표시 가능 | 어떤 문서를 보고 답했는지 같이 보여줄 수 있어요 |
| 비용 절약 | 문서 전체가 아니라 관련 조각 3개만 보내니 토큰이 확 줄어요 |
| 거짓말 감소 | "문서에 없으면 없다고 해"라고 규칙을 줄 수 있어요 |
📌 준비물
- Python 3.9 이상 (Anthropic SDK가 3.9+ 를 요구해요)
discord.py2.x — 슬래시 명령어용- openai 2.x — 임베딩(검색)용
- anthropic 0.x — 답변 생성용
- numpy 2.x — 유사도 계산용
pip install discord.py openai anthropic numpy필요한 키는 3개예요.
| 키 | 어디서 받나요? |
|---|---|
| 디스코드 봇 토큰 | Discord Developer Portal에서 발급 (#1편 참고) |
| OpenAI API 키 | platform.openai.com — 임베딩용 |
| Anthropic API 키 | Claude 콘솔 — 답변 생성용 |
폴더는 이렇게 준비해주세요.
my-rag-bot/
├── docs/              ← 여기에 문서(.txt / .md)를 넣어요
│   ├── 서버규칙.txt
│   └── 모드설치가이드.md
├── build_index.py     ← 색인 만드는 스크립트 (한 번만 실행)
└── rag_bot.py         ← 실제 봇
💡 키는 코드에 직접 적지 말고 환경변수로 넣어주세요. 윈도우는
set OPENAI_API_KEY=sk-..., 맥·리눅스는export OPENAI_API_KEY=sk-...예요.
📌 1단계 - 문서를 조각내기 (청킹)
문서를 통째로 AI에게 주면 토큰이 폭발해요. 그래서 500글자씩 잘라서 씁니다.
CHUNK_SIZE = 500      # 조각 하나의 글자 수
CHUNK_OVERLAP = 100   # 조각끼리 겹칠 글자 수

def split_text(text, size=CHUNK_SIZE, overlap=CHUNK_OVERLAP):
    chunks, start = [], 0
    while start < len(text):
        piece = text[start:start + size].strip()
        if piece:
            chunks.append(piece)
        start += size - overlap
    return chunks
하나씩 뜯어볼게요 💡
| 코드 | 설명 |
|---|---|
| CHUNK_SIZE = 500 | 한 조각의 크기예요. 너무 작으면 문맥이 끊기고, 너무 크면 엉뚱한 내용까지 딸려와요 |
| CHUNK_OVERLAP = 100 | 조각끼리 100글자를 일부러 겹치게 잘라요. 중요한 문장이 조각 경계에서 반토막 나는 걸 막아줍니다 |
| start += size - overlap | 그래서 400글자씩만 전진해요. ⚠️ size가 overlap보다 커야 무한 루프가 안 나요! |
1,200글자 문서를 넣으면 500 / 500 / 400 이렇게 3조각이 나와요.
📌 2단계 - 조각을 임베딩으로 바꿔 저장하기
임베딩(Embedding) 은 글을 숫자 목록(벡터) 으로 바꾼 거예요. 의미가 비슷한 글끼리는 숫자도 비슷하게 나옵니다. 그래서 "규칙"과 "수칙"처럼 글자는 달라도 뜻이 비슷하면 검색이 돼요. 단순 키워드 검색과 결정적으로 다른 점이죠!
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
EMBED_MODEL = "text-embedding-3-small"

def embed_all(texts):
    vectors = []
    for i in range(0, len(texts), 100):     # 100개씩 끊어서 요청
        batch = texts[i:i + 100]
        res = client.embeddings.create(model=EMBED_MODEL, input=batch)
        vectors.extend([d.embedding for d in res.data])
        print(f"  임베딩 {i + len(batch)}/{len(texts)} 완료")
return vectors| 항목 | 설명 |
|---|---|
| text-embedding-3-small | OpenAI의 가벼운 임베딩 모델이에요. 벡터 길이는 1536차원 |
| input=batch | 리스트로 한 번에 여러 개를 보낼 수 있어요. 100개씩 묶으면 훨씬 빨라요 |
res.data[i].embedding |
결과는 data 리스트로 오고, 순서는 보낸 순서 그대로예요 |
💰 비용이 궁금하시죠?
text-embedding-3-small은 100만 토큰당 약 $0.02 수준이에요. A4 100쪽짜리 문서를 통째로 색인해도 몇 원 수준입니다. (대략치이고 요금은 바뀔 수 있으니 공식 가격표를 확인해주세요!)
만든 벡터는 index.json 파일 하나에 저장해요. #14편에서 다룬 JSON 저장을 그대로 쓰는 거예요 👍
📌 3단계 - 질문과 가장 비슷한 조각 찾기
이제 검색 차례예요. 두 벡터가 얼마나 비슷한지는 코사인 유사도(Cosine Similarity) 로 재요. 값은 -1 ~ 1 사이이고, 1에 가까울수록 비슷하다는 뜻이에요.
import numpy as np

# 미리 전부 길이 1로 맞춰두면(정규화) 나중에 곱셈만 하면 끝!
MATRIX = np.array([it["embedding"] for it in ITEMS], dtype="float32")
MATRIX = MATRIX / np.linalg.norm(MATRIX, axis=1, keepdims=True)

def search(question, top_k=3):
    res = openai_client.embeddings.create(model=EMBED_MODEL, input=[question])
    q = np.array(res.data[0].embedding, dtype="float32")
    q = q / np.linalg.norm(q)

    scores = MATRIX @ q                      # 한 방에 전체 유사도 계산
    top = np.argsort(scores)[::-1][:top_k]   # 점수 높은 순 top_k개
    return [(ITEMS[i], float(scores[i])) for i in top]
하나씩 뜯어볼게요 💡
| 코드 | 설명 |
|---|---|
np.linalg.norm(...) 으로 나누기 |
벡터 길이를 1로 맞추는 정규화예요. 이러면 코사인 유사도가 그냥 내적(곱셈) 이 돼요 |
MATRIX @ q |
@는 행렬 곱이에요. 반복문 없이 모든 조각의 점수를 한 번에 구합니다 |
np.argsort(scores)[::-1] |
argsort는 오름차순이라 [::-1]로 뒤집어서 높은 점수부터 가져와요 |
float(scores[i]) |
numpy 숫자를 파이썬 float로 바꿔줘야 나중에 포매팅이 편해요 |
조각이 몇천 개까지는 이 방식으로 충분히 빨라요. 벡터DB 없이도 됩니다!
📌 4단계 - 찾은 조각으로 Claude에게 답변 시키기
찾은 조각 3개를 그대로 붙여서 프롬프트로 넘겨요. 여기서 시스템 프롬프트가 핵심이에요.
from anthropic import Anthropic

claude = Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
CHAT_MODEL = "claude-sonnet-5"

SYSTEM_PROMPT = (
    "당신은 디스코드 서버의 문서 도우미입니다. "
    "반드시 아래 '문서' 안의 내용만 근거로 한국어로 답하세요. "
    "문서에 없는 내용이면 지어내지 말고 '문서에서 찾지 못했어요'라고 답하세요. "
    "답변은 3~5문장으로 짧게 정리하세요."
)

def make_answer(question, hits):
    context = "\n\n".join(
        f"[{i + 1}] ({it['source']})\n{it['text']}"
        for i, (it, _) in enumerate(hits)
    )
    msg = claude.messages.create(
        model=CHAT_MODEL,
        max_tokens=600,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": f"문서:\n{context}\n\n질문: {question}"}],
    )
return msg.content[0].text| 항목 | 설명 |
|---|---|
| "문서 안의 내용만 근거로" | 이 한 줄이 거짓말을 막는 핵심이에요. 빼면 봇이 상상해서 답합니다 😅 |
| '문서에서 찾지 못했어요' | 모를 때 어떻게 답할지 탈출구를 미리 지정해주는 거예요 |
system= |
messages에 섞지 말고 system 파라미터로 따로 넘기는 게 정석이에요 |
msg.content[0].text |
Claude 응답은 블록 리스트라 첫 블록의 .text를 꺼내요 |
📌 5단계 - 디스코드 슬래시 명령어로 연결하기
마지막! 여기서 놓치면 100% 터지는 함정 2개가 있어요.
@bot.tree.command(name="질문", description="서버 문서에서 찾아 답변해드려요")
@discord.app_commands.describe(내용="궁금한 내용을 적어주세요")
async def ask(interaction: discord.Interaction, 내용: str):
    await interaction.response.defer(thinking=True)   # ① 3초 제한 회피
    hits = await asyncio.to_thread(search, 내용)       # ② 블로킹 → 스레드로
    answer = await asyncio.to_thread(make_answer, 내용, hits)

    embed = discord.Embed(title="📚 문서 기반 답변", description=answer[:4000],
                          color=0x5865F2)
    await interaction.followup.send(embed=embed)
하나씩 뜯어볼게요 💡
| 코드 | 설명 |
|---|---|
defer(thinking=True) |
디스코드는 3초 안에 응답하지 않으면 "애플리케이션이 응답하지 않았습니다" 에러를 띄워요. AI 답변은 5~10초 걸리니 먼저 "생각 중..."으로 시간을 벌어야 해요 |
followup.send() |
defer를 했으면 그다음은 response.send_message가 아니라 followup.send 로 보내야 해요 |
asyncio.to_thread(...) |
OpenAI·Anthropic 기본 클라이언트는 동기(blocking) 라서 그냥 부르면 봇 전체가 멈춰요. 별도 스레드로 넘겨야 다른 명령어도 정상 동작합니다 |
answer[:4000] |
임베드 설명은 최대 4096자예요. 잘라주는 게 안전해요 (#8편 참고) |
📌 전체 코드 (복붙 OK)
1) build_index.py — 색인 만들기 (문서 바뀔 때만 실행)
# 파이썬 3.9+ / openai 2.x / numpy 2.x
# 문서를 조각내서 임베딩으로 바꾼 뒤 index.json 으로 저장합니다.
import os
import json
import glob
from openai import OpenAI

DOCS_DIR = "docs"
INDEX_FILE = "index.json"
EMBED_MODEL = "text-embedding-3-small"
CHUNK_SIZE = 500
CHUNK_OVERLAP = 100

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

def split_text(text, size=CHUNK_SIZE, overlap=CHUNK_OVERLAP):
    """긴 글을 size 글자씩, overlap 만큼 겹치게 잘라줍니다."""
    chunks, start = [], 0
    while start < len(text):
        piece = text[start:start + size].strip()
        if piece:
            chunks.append(piece)
        start += size - overlap
    return chunks

def load_chunks():
    items = []
    paths = sorted(glob.glob(os.path.join(DOCS_DIR, "*.txt")) +
                   glob.glob(os.path.join(DOCS_DIR, "*.md")))
    for path in paths:
        with open(path, encoding="utf-8") as f:
            text = f.read()
        for i, piece in enumerate(split_text(text)):
            items.append({
                "source": os.path.basename(path),
                "chunk_id": i,
                "text": piece,
            })
    return items

def embed_all(texts):
    vectors = []
    for i in range(0, len(texts), 100):
        batch = texts[i:i + 100]
        res = client.embeddings.create(model=EMBED_MODEL, input=batch)
        vectors.extend([d.embedding for d in res.data])
        print(f"  임베딩 {i + len(batch)}/{len(texts)} 완료")
    return vectors

def main():
    items = load_chunks()
    if not items:
        print("❌ docs 폴더에 .txt 또는 .md 파일을 먼저 넣어주세요!")
        return
    print(f"조각 {len(items)}개를 임베딩할게요...")
    vectors = embed_all([it["text"] for it in items])
    for it, vec in zip(items, vectors):
        it["embedding"] = vec
    with open(INDEX_FILE, "w", encoding="utf-8") as f:
        json.dump({"model": EMBED_MODEL, "items": items}, f, ensure_ascii=False)
    print(f"✅ {INDEX_FILE} 저장 완료! (조각 {len(items)}개)")

if __name__ == "__main__":
    main()
2) rag_bot.py — 실제 봇
# discord.py 2.x / 파이썬 3.9+ / openai 2.x / anthropic 0.x / numpy 2.x
import os
import json
import asyncio

import numpy as np
import discord
from discord.ext import commands
from openai import OpenAI
from anthropic import Anthropic

DISCORD_TOKEN = os.environ["DISCORD_TOKEN"]
openai_client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
claude = Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])

EMBED_MODEL = "text-embedding-3-small"
CHAT_MODEL = "claude-sonnet-5"
TOP_K = 3          # 몇 조각을 참고할지
MIN_SCORE = 0.25   # 이보다 유사도가 낮으면 "못 찾았어요"

# --- 색인 불러오기 ---
with open("index.json", encoding="utf-8") as f:
    index = json.load(f)

ITEMS = index["items"]
MATRIX = np.array([it["embedding"] for it in ITEMS], dtype="float32")
MATRIX = MATRIX / np.linalg.norm(MATRIX, axis=1, keepdims=True)

def search(question, top_k=TOP_K):
    res = openai_client.embeddings.create(model=EMBED_MODEL, input=[question])
    q = np.array(res.data[0].embedding, dtype="float32")
    q = q / np.linalg.norm(q)
    scores = MATRIX @ q
    top = np.argsort(scores)[::-1][:top_k]
    return [(ITEMS[i], float(scores[i])) for i in top]

SYSTEM_PROMPT = (
    "당신은 디스코드 서버의 문서 도우미입니다. "
    "반드시 아래 '문서' 안의 내용만 근거로 한국어로 답하세요. "
    "문서에 없는 내용이면 지어내지 말고 '문서에서 찾지 못했어요'라고 답하세요. "
    "답변은 3~5문장으로 짧게 정리하세요."
)

def make_answer(question, hits):
    context = "\n\n".join(
        f"[{i + 1}] ({it['source']})\n{it['text']}"
        for i, (it, _) in enumerate(hits)
    )
    msg = claude.messages.create(
        model=CHAT_MODEL,
        max_tokens=600,
        system=SYSTEM_PROMPT,
        messages=[{"role": "user", "content": f"문서:\n{context}\n\n질문: {question}"}],
    )
    return msg.content[0].text

intents = discord.Intents.default()

class RagBot(commands.Bot):
    def __init__(self):
        super().__init__(command_prefix="!", intents=intents)

    async def setup_hook(self):
        await self.tree.sync()

bot = RagBot()

@bot.event
async def on_ready():
    print(f"✅ 로그인 완료: {bot.user} / 문서 조각 {len(ITEMS)}개")

@bot.tree.command(name="질문", description="서버 문서에서 찾아 답변해드려요")
@discord.app_commands.describe(내용="궁금한 내용을 적어주세요")
async def ask(interaction: discord.Interaction, 내용: str):
    await interaction.response.defer(thinking=True)
    try:
        hits = await asyncio.to_thread(search, 내용)
        if not hits or hits[0][1] < MIN_SCORE:
            await interaction.followup.send("🤔 문서에서 관련 내용을 찾지 못했어요.")
            return
        answer = await asyncio.to_thread(make_answer, 내용, hits)
    except Exception as e:
        await interaction.followup.send(f"⚠️ 답변을 만들지 못했어요: {e}")
        return

    embed = discord.Embed(
        title="📚 문서 기반 답변",
        description=answer[:4000],
        color=0x5865F2,
    )
    embed.add_field(
        name="🔎 참고한 문서",
        value="\n".join(
            f"[{i + 1}] {it['source']} (유사도 {score:.2f})"
            for i, (it, score) in enumerate(hits)
        ),
        inline=False,
    )
    embed.set_footer(text=f"질문: {내용[:80]}")
    await interaction.followup.send(embed=embed)

bot.run(DISCORD_TOKEN)
📌 실행 결과
순서는 딱 두 줄이에요.
python build_index.py    # ① 색인 만들기 (문서 바뀔 때만)
python rag_bot.py        # ② 봇 실행
① 을 실행하면 이렇게 나와요.
조각 12개를 임베딩할게요...
  임베딩 12/12 완료
✅ index.json 저장 완료! (조각 12개)
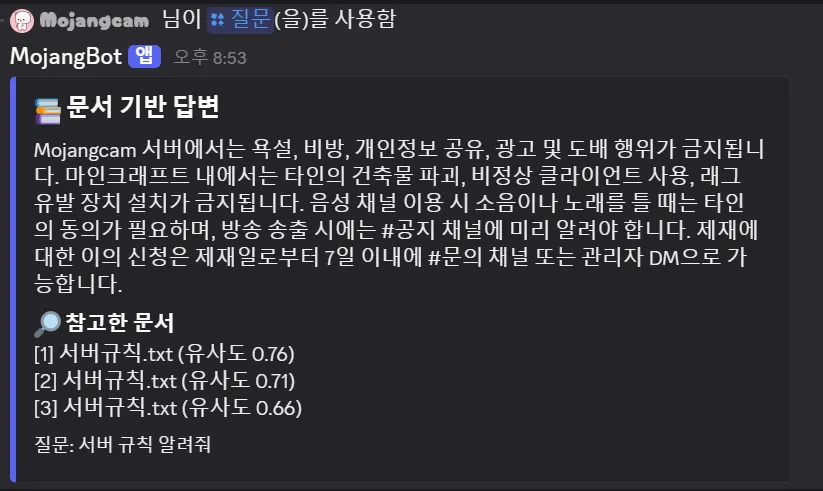
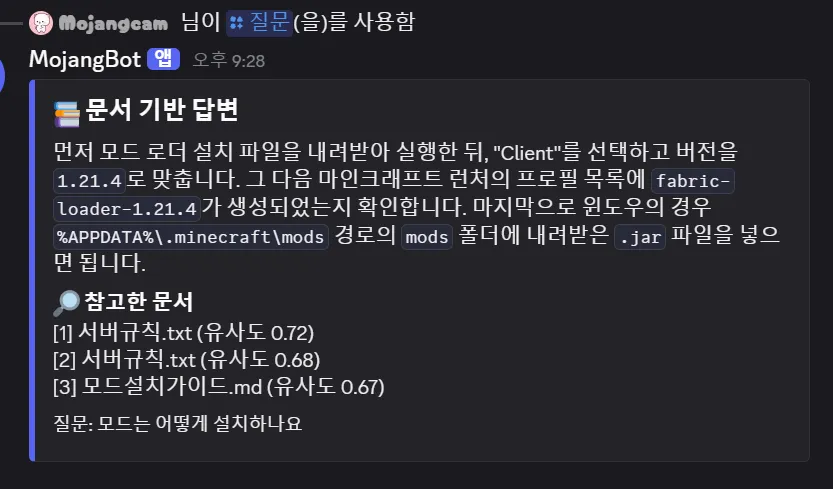
② 를 실행하고 디스코드에서 /질문 서버 규칙 알려줘 를 입력하면, 봇이 잠깐 "생각 중..."을 띄운 뒤 문서에서 찾은 내용으로 답변 + 참고 문서 목록을 임베드로 보내줘요!
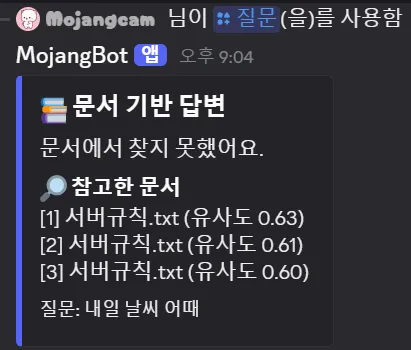
문서에 없는 걸 물어보면? 🤔 문서에서 관련 내용을 찾지 못했어요. 라고 솔직하게 답해요. 이게 RAG의 매력이에요 😎
📌 자주 나는 에러
1. FileNotFoundError: index.json
- 원인 :
build_index.py를 실행하지 않고 바로 봇을 켰어요 - 해결 :
python build_index.py를 먼저 한 번 돌려주세요
2. KeyError: 'OPENAI_API_KEY'
- 원인 : 환경변수가 설정되지 않았어요
- 해결 : 터미널에서
set OPENAI_API_KEY=sk-...(윈도우) /export OPENAI_API_KEY=sk-...(맥·리눅스). ⚠️ 환경변수는 터미널 창마다 따로 잡히니, 봇을 켤 그 터미널에서 설정해야 해요
3. "애플리케이션이 응답하지 않았습니다"
- 원인 : 3초 안에 응답을 못 했어요
- 해결 : 명령어 맨 앞에
await interaction.response.defer(thinking=True)를 꼭 넣으세요
4. 봇이 명령어 하나 쓰는 동안 완전히 멈춰요
- 원인 : 동기 API 호출이 이벤트 루프를 붙잡고 있어요
- 해결 :
await asyncio.to_thread(함수, 인자)로 감싸세요. (asyncio.to_thread는 파이썬 3.9 이상에서 써요)
5. 엉뚱한 문서를 물어와요
- 원인 : 조각이 너무 크거나(문맥 뒤섞임) 너무 작아요(문맥 부족)
- 해결 :
CHUNK_SIZE를 300~800 사이에서 조절하고 색인을 다시 만드세요.TOP_K를 5로 올려보는 것도 방법이에요
6. openai.RateLimitError 또는 insufficient_quota
- 원인 : API 키에 크레딧이 없거나 분당 요청 한도를 넘었어요
- 해결 : 결제 정보·잔액을 확인하고, 색인할 때는 배치 크기(100)를 50 정도로 줄여보세요
7. 한글이 \uc11c\ubc84 처럼 깨져서 저장돼요
- 원인 :
json.dump()기본값이 아스키 변환이에요 - 해결 :
ensure_ascii=False를 꼭 넣어주세요 (전체 코드엔 이미 들어가 있어요!)
💡 보너스 팁 3가지
① 키를 하나만 쓰고 싶다면? make_answer() 안쪽만 OpenAI 채팅 모델로 바꾸면 돼요. 임베딩·답변 둘 다 OpenAI 키 하나로 끝납니다.
② 문서를 바꿨는데 봇이 옛날 내용을 답해요. 당연해요! index.json은 자동으로 갱신되지 않아요. 문서를 고쳤으면 build_index.py를 다시 돌리고 봇을 재시작해주세요.
③ 조각이 수만 개로 늘어나면? 그때는 JSON 대신 벡터DB(Chroma, FAISS 등)로 옮기는 걸 권해요. 하지만 서버 공지·규칙 정도라면 오늘 방식으로 충분합니다 👍
📌 마무리
오늘은 RAG로 문서 기반 답변봇을 만들어봤어요! 정리하면 이렇습니다 💬
- 문서를 500자씩 겹치게 조각내고
- 임베딩으로 바꿔
index.json에 저장하고 - 질문이 오면 코사인 유사도로 비슷한 조각 3개를 찾아
- Claude에게 "이것만 보고 답해" 라고 시키는 것
생각보다 어렵지 않죠? 벡터DB도, 파인튜닝도 없이 numpy 곱셈 한 줄로 검색이 끝났어요 😎
다음 편에서는 오늘 만든 봇을 서버 사람들이 실제로 쓸 수 있게 다듬어볼게요. 질문 로그를 남기고, 자주 나온 질문을 통계로 뽑는 기능을 붙여볼 예정이에요. 기대해주세요! 🙌
📚 디스코드 봇 만들기 시리즈
- #5 - 버튼(Button) 상호작용 구현하기
- #6 - 드롭다운(Select Menu) 메뉴 구현하기
- #7 - 모달(Modal)로 입력 받기
- #8 - 임베드(Embed) 이미지·필드로 꾸미기
- #9 - AI(Claude·ChatGPT API) 연동하기
- #10 - 다국어(i18n) 지원하기
- #11 - 플라스크(Flask)로 웹 대시보드 만들기
- #12 - 명령어 쿨다운(Cooldown)·권한(Permission) 관리하기
- #13 - 역할·채널 자동화로 서버 관리하기
- #14 - 데이터 저장하기! JSON vs SQLite
- #15 - 슬래시 명령어 그룹(Group)으로 명령어 정리하기
- #16 - 리마인더·알림 기능 만들기
- #17 - RAG로 문서 기반 답변봇 만들기 ← 지금 이 글!
💬 궁금한 점은 댓글로 남겨주세요. 다음 편에서 만나요!
연재 · 32편 중 17번째
디스코드 봇 만들기
- #1디스코드 봇 만들기 - Slash Command 완전 정복!
- #2Slash Command에 옵션(Arguments) 추가하기!
- #3Slash Command에 서브 커맨드(Subcommand) 넣기!
- #4Slash Command로 임베드 전송하기!
- #5버튼(Button) 상호작용 구현하기!
- #6드롭다운(Select Menu) 메뉴 구현하기!
- #7모달(Modal)로 입력 받기 구현하기 (파이썬 예제)
- #8임베드(Embed) 이미지·필드로 꾸미기 (파이썬 예제)
- #9AI(Claude·ChatGPT API) 연동하기! (파이썬 예제)
- #10다국어(i18n) 지원하기! (파이썬 예제)
- #11플라스크(Flask)로 웹 대시보드 만들기! (파이썬 예제)
- #12명령어 쿨다운(Cooldown)·권한(Permission) 관리하기! (파이썬 예제)
- #13역할·채널 자동화로 서버 관리하기! (파이썬 예제)
- #14데이터 저장하기! JSON vs SQLite (파이썬 예제)
- #15슬래시 명령어 그룹(Group)으로 명령어 정리하기! (파이썬 예제)
- #16리마인더·알림 기능 만들기! 봇이 먼저 말 걸게 하기 (파이썬 예제)
- #17RAG로 문서 기반 답변봇 만들기! 우리 서버 전용 FAQ 봇 (파이썬 예제)지금 읽는 글
- #18투표(Poll) 기능 만들기! 다수결로 정하는 서버 규칙 (파이썬 예제)
- #19Cog로 코드 쪼개기! 1000줄 봇도 안 더러워지는 구조 (파이썬 예제)
- #20자동 환영 메시지·온보딩 만들기! 규칙 동의 버튼으로 자동 역할 부여 (파이썬 예제)
- #21키워드 자동응답·금지어 필터 만들기! 경고 누적으로 자동 제재까지 (파이썬 예제)
- #22슬래시 명령어 자동완성(Autocomplete) 만들기! 금지어를 골라서 추가·삭제 (파이썬 예제)
- #23aiosqlite로 비동기 DB 제대로 설계하기! JSON 탈출 (파이썬 예제)
- #24채널 난독화(Channel Obfuscation) 대응하기! 11/16부터 안 보이는 채널이 생겨요 (파이썬 예제)
- #25봇이 죽지 않게! 에러 핸들링·로깅 체계 잡기 (파이썬 예제)
- #26티켓(Ticket) 문의 시스템 만들기! 버튼 하나로 1:1 상담 채널 자동 생성 (파이썬 예제)
- #27티켓 담당자 배정·우선순위 만들기! 스태프가 여러 명이어도 안 꼬이게 (파이썬 예제)
- #28레벨·경험치(XP) 시스템 만들기! 채팅할수록 레벨업, 랭킹판까지 (파이썬 예제)
- #29화폐·상점(Economy) 시스템 만들기! 코인 벌어서 아이템 사기 (파이썬 예제)
- #30투표·설문(Poll) 봇 만들기! 네이티브 투표 + 버튼으로 실시간 집계까지 (파이썬 예제) 🗳️
- #32서버 로그·감사(Audit Log) 채널 만들기! 메시지 삭제·수정·입퇴장·추방까지 자동 기록 (파이썬 예제) 🕵️
- #33임시 음성방 확장, 파티방 만들기! 방장 위임·강퇴·초대 전용(비공개) 방 + 전용 채팅방 자동 생성 (파이썬 예제) 🎉
전체 32편 보기접기
