
파이썬 웹 크롤링 실전 - 뉴스 수집 자동화! RSS로 매일 아침 기사 모으기 (feedparser) 📰
 글쓴이 Mojangcam
목차13개 항목
안녕하세요! Mojangcam입니다 😎
지난 파이썬 업무 자동화 #2 - 웹 크롤링 입문 (requests + BeautifulSoup)에서는 웹 페이지를 통째로 가져와서 원하는 부분만 뽑아 CSV로 저장하는 것까지 해봤죠. 그 글을 보고 이런 댓글이 제일 많이 왔어요.
"그래서 뉴스는 어떻게 긁어요? 따라 했더니 403 뜨는데요 😭"
네, 뉴스 사이트는 입문 예제처럼 안 됩니다. 오늘은 그 이유를 짚고, 실제로 매일 돌려도 안 막히고 법적으로도 안전한 뉴스 수집기를 처음부터 끝까지 만들어볼게요.
이번 편에서 배울 것
- 뉴스는 왜 HTML 크롤링이 아니라 RSS로 가져와야 하는지
feedparser로 RSS 읽고 제목·링크·발행일 뽑기- 관심 키워드가 들어간 기사만 골라내기
- 어제 본 기사를 또 저장하지 않는 중복 제거(SQLite)
- 엑셀로 열리는 CSV 저장 + 디스코드 알림까지
robots.txt와 저작권 — 이거 모르고 돌리면 진짜 큰일 나요 ⚠️
매일 아침 "내 업계 뉴스 있나" 하고 사이트 5개를 순회하고 계셨다면, 오늘 이후로는 디스코드 알림 하나로 끝납니다 💡
🧠 왜 뉴스는 RSS로 가져와야 하나요?
입문 편에서 배운 대로 뉴스 사이트에 requests.get()을 날리면 십중팔구 이렇게 됩니다.
- 403 Forbidden — 봇이라고 판단해서 차단
- 빈 껍데기 HTML — 기사 목록을 자바스크립트로 나중에 그리는 사이트
- 어제 되던 코드가 오늘 안 됨 — 사이트 개편 한 번에 CSS 선택자 전멸 😇
- 그리고 가장 무서운 것 → 기사 본문 전문을 긁어 저장하면 저작권 침해
그런데 대부분의 언론사는 "우리 기사 목록 가져가세요" 하고 RSS 피드를 공식으로 열어둡니다. RSS는 기사 제목·링크·요약·발행일이 정해진 XML 규격으로 들어 있는 주소예요.
| 항목 | HTML 크롤링 | RSS 피드 |
|---|---|---|
| 차단 위험 | 높음 (403·IP 밴) | 낮음 (공개 배포용) |
| 구조 변경 | 사이트 개편마다 깨짐 | 규격이 고정 |
| 파싱 난이도 | 선택자 계속 손봐야 함 | 라이브러리가 다 해줌 |
| 저작권 | 본문 전문 저장 시 위험 | 제목·요약·링크는 안전 |
| 속도 | 페이지 전체 다운로드 | 목록만 (가벼움) |
정리하면 "제목·요약·링크는 RSS로 모으고, 본문은 원문 링크로 보낸다" 가 정답이에요. 우리가 오늘 만들 것도 딱 이 방식입니다.
내가 보는 언론사 RSS 주소 찾는 법
- 사이트 하단에 있는 RSS 아이콘 클릭 (제일 확실해요)
- 주소 뒤에
/rss,/feed,/rss.xml붙여보기 - 그래도 없으면 검색창에
언론사명 RSS로 검색
키워드로 여러 언론사를 한 번에 훑고 싶다면 구글 뉴스 검색 RSS가 편해요. q= 뒤에 검색어를 URL 인코딩해서 넣으면 됩니다.
https://news.google.com/rss/search?q=검색어&hl=ko&gl=KR&ceid=KR:ko📌 준비물
- Python 3.10 이상 (feedparser 6.0.14부터 3.10+ 필수예요)
- feedparser 6.0.x — 작성 기준 최신 6.0.14
- requests 2.34.x — 피드 받아오기
- beautifulsoup4 4.15.x + lxml — 요약문에 섞인 HTML 태그 청소
- python-dotenv 1.x — 디스코드 웹훅 주소를 코드 밖으로 빼기
- sqlite3 · csv · calendar — 파이썬 내장이라 설치 불필요 🎉
pip install feedparser requests beautifulsoup4 lxml python-dotenv버전이 궁금하면 이렇게 확인해요.
pip show feedparser | findstr Version📌 1단계 - RSS 한 번 읽어보기
먼저 피드가 잘 열리는지부터 확인할게요.
import feedparser
import requests

HEADERS = {"User-Agent": "Mojangcam-NewsBot/1.0 (+https://mojangcam.tistory.com)"}
URL = "https://news.google.com/rss/search?q=%ED%8C%8C%EC%9D%B4%EC%8D%AC&hl=ko&gl=KR&ceid=KR:ko"

res = requests.get(URL, headers=HEADERS, timeout=10)
res.raise_for_status()

parsed = feedparser.parse(res.content)
print("기사 수:", len(parsed.entries))

for entry in parsed.entries[:3]:
    print("-", entry.title)
    print("  ", entry.link)
하나씩 뜯어볼게요 💡
- User-Agent : 누가 요청하는지 밝히는 명함이에요. 기본값(
python-requests/…)으로 두면 차단당하기 쉬워요. 연락 가능한 주소를 같이 적어두면 서버 관리자가 오해하지 않습니다. - timeout=10 : 응답 없는 서버에 영원히 매달리지 않게 하는 안전장치. 자동 실행 스크립트에서는 필수예요.
- raise_for_status() : 403·404·500이면 바로 예외를 던져줘요. 조용히 실패해서 "0건 수집"만 뜨는 게 제일 무섭거든요.
- feedparser.parse(res.content) :
res.text가 아니라res.content(바이트)를 넘기세요. 그래야 feedparser가 XML 선언부를 보고 인코딩을 스스로 판단해서 한글이 안 깨집니다.
💬
feedparser.parse(URL)처럼 주소를 바로 넘길 수도 있어요. 다만 그러면 User-Agent·타임아웃·재시도를 우리가 못 만지니까, 실전에서는 requests로 받아서 넘기는 쪽을 권해요.

📌 2단계 - 필요한 것만 뽑아내기 (필터 + 태그 청소)
RSS를 열어보면 요약문에 <p>, <b> 같은 태그가 섞여 들어와요. 그리고 기사가 100건씩 오는데 내가 볼 건 3건이죠. 정리해봅시다.
import calendar
import re
from datetime import datetime, timezone, timedelta

from bs4 import BeautifulSoup

KST = timezone(timedelta(hours=9))
KEYWORDS = ["파이썬", "AI"]

def clean(html_text: str) -> str:
    """요약문에 섞인 HTML 태그를 제거하고 공백을 정리해요."""
    if not html_text:
        return ""
    text = BeautifulSoup(html_text, "lxml").get_text(" ", strip=True)
    return re.sub(r"\s+", " ", text).strip()

def to_kst(entry) -> str:
    """RSS 발행 시각을 한국 시간 문자열로 바꿔요."""
    t = entry.get("published_parsed") or entry.get("updated_parsed")
    if not t:
        return ""
    dt = datetime.fromtimestamp(calendar.timegm(t), tz=timezone.utc)
    return dt.astimezone(KST).strftime("%Y-%m-%d %H:%M")

def match_keyword(title: str, summary: str) -> bool:
    if not KEYWORDS:
        return True
    blob = f"{title} {summary}".lower()
    return any(k.lower() in blob for k in KEYWORDS)
하나씩 뜯어볼게요 💡
- get_text(" ", strip=True) : 태그를 걷어내고 텍스트만 남기되, 사이에 공백 한 칸을 넣어줘요. 이걸 빼면
제목본문첫문단처럼 단어가 다 붙어버립니다. - re.sub(r"\s+", " ", text) : 줄바꿈·탭·연속 공백을 한 칸으로 눌러줘요. 정규식이 낯설다면 파이썬 정규표현식(re) 입문 편을 보고 오세요!
- published_parsed : feedparser가 날짜 문자열을
time.struct_time으로 파싱해둔 값이에요. 언론사마다Wed, 19 Aug 2026 09:30:00 +0900/2026-08-19T09:30:00Z등 형식이 제각각인데, 이 필드는 항상 UTC 기준으로 통일돼 있어요.
⚠️ 여기 함정 하나 있어요 (제가 당했습니다 😇)
published_parsed를time.mktime()으로 변환하는 코드를 인터넷에서 자주 보실 텐데, 틀린 코드예요.mktime()은 넘겨받은 값을 내 컴퓨터 시간대로 해석하거든요. 한국 PC에서 돌리면 이미 UTC인 값을 또 KST로 취급해서 9시간이 밀립니다. 실제로 09:30 기사가 00:30으로 찍혔어요. UTC를 UTC로 읽는calendar.timegm()을 쓰세요.
📌 3단계 - 어제 본 기사는 그만 (중복 제거)
수집기를 30분마다 돌리면 같은 기사가 계속 들어와요. RSS 안에 같은 기사가 두 번 들어있는 경우도 흔하고요. 기사 링크를 기본키로 쓰는 SQLite 테이블 하나면 깔끔하게 해결됩니다.
import sqlite3

DB_PATH = "news.db"

def init_db():
    conn = sqlite3.connect(DB_PATH)
    conn.execute("""
        CREATE TABLE IF NOT EXISTS seen (
            link       TEXT PRIMARY KEY,
            title      TEXT NOT NULL,
            source     TEXT,
            published  TEXT,
            collected  TEXT NOT NULL
        )
    """)
    conn.commit()
    return conn
하나씩 뜯어볼게요 💡
- link TEXT PRIMARY KEY : 링크를 기본키로 잡으면 같은 주소는 애초에 두 번 못 들어와요. 제목으로 비교하면 언론사가 제목을 살짝 고칠 때 중복이 새어 들어옵니다.
- CREATE TABLE IF NOT EXISTS : 이미 있으면 그냥 넘어가요. 덕분에 매번 실행해도 안전해요.
- 텍스트 파일(JSON) 말고 왜 DB냐면 : 기사가 수천 건 쌓여도
SELECT가 즉시 끝나고, 스크립트가 중간에 죽어도 파일이 통째로 날아가지 않아요. 이 이야기는 디스코드 봇 만들기 #23 - aiosqlite로 비동기 DB 제대로 설계하기 편에서 숫자로 보여드렸어요.
📌 4단계 - CSV 저장 + 디스코드 알림 (.env로 안전하게)
수집했으면 남겨야죠. 엑셀로 바로 열리는 CSV로 쌓고, 새 기사가 있으면 디스코드로 쏴줍니다.
여기서 중요한 것 하나! 디스코드 웹훅 주소는 비밀번호나 마찬가지예요. 그 주소만 있으면 누구나 내 채널에 글을 쓸 수 있거든요. 코드에 박아두고 깃허브에 올리면… 광고 봇의 놀이터가 됩니다 😱 그래서 .env 파일로 뺍니다.
.env (스크립트와 같은 폴더에 만들어요)
NEWS_KEYWORDS=파이썬,AI,반도체
DISCORD_WEBHOOK_URL=https://discord.com/api/webhooks/여기에_본인_웹훅_주소
.gitignore
.env
news.db
news.csvimport csv
import os
from dotenv import load_dotenv
load_dotenv()
KEYWORDS = [k.strip() for k in os.getenv("NEWS_KEYWORDS", "").split(",") if k.strip()]
WEBHOOK_URL = os.getenv("DISCORD_WEBHOOK_URL")
CSV_PATH = "news.csv"
def save_csv(items):
if not items:
return
is_new_file = not os.path.exists(CSV_PATH)
with open(CSV_PATH, "a", newline="", encoding="utf-8-sig") as f:
writer = csv.DictWriter(f, fieldnames=list(items[0].keys()))
if is_new_file:
writer.writeheader()
writer.writerows(items)
DISCORD_LIMIT = 2000
def notify_discord(items):
if not WEBHOOK_URL or not items:
return
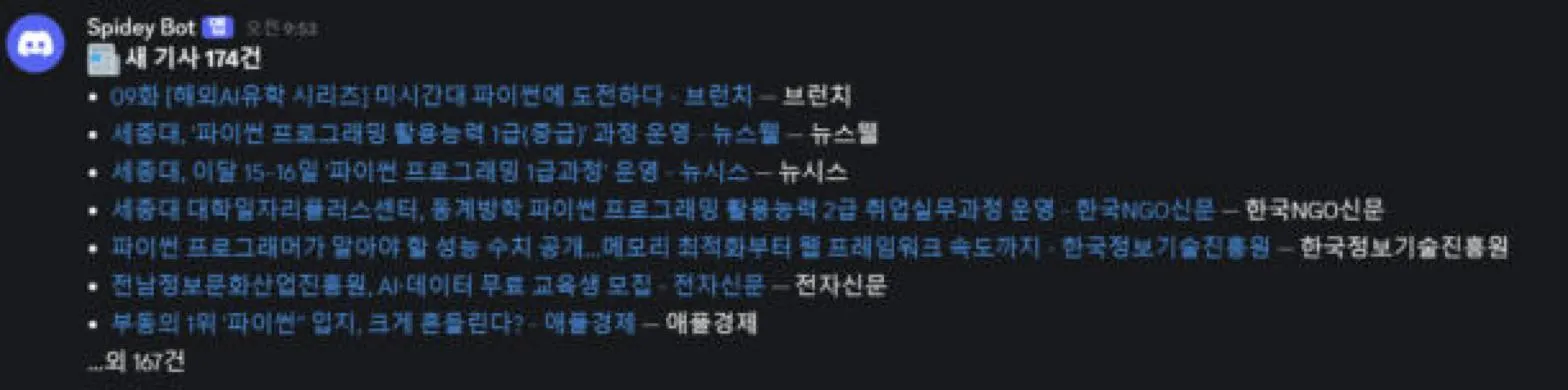
lines = [f"📰 **새 기사 {len(items)}건**"]
for item in items:
line = f"- [{item['제목']}]({item['링크']}) — {item['출처']}"
# 2,000자를 넘기 직전에 멈춰요
if len("\n".join(lines + [line])) > DISCORD_LIMIT - 40:
lines.append(f"…외 {len(items) - (len(lines) - 1)}건")
break
lines.append(line)
res = requests.post(
WEBHOOK_URL,
json={"content": "\n".join(lines), "flags": 4}, # flags=4 : 링크 미리보기 끄기
timeout=10,
)
res.raise_for_status() # 조용히 실패하지 않게!하나씩 뜯어볼게요 💡
- encoding="utf-8-sig" : 그냥
utf-8로 저장하면 엑셀에서 열었을 때 한글이 죄다 깨져요.utf-8-sig는 파일 앞에 표식(BOM)을 붙여줘서 엑셀이 알아서 한글로 읽습니다. 이거 하나로 스트레스 절반이 줄어요! - newline="" : 윈도우에서 이걸 빼면 한 줄씩 건너뛴 CSV가 만들어져요. 파이썬 공식 문서가 지정한 필수 옵션입니다.
- mode="a" : 이어쓰기. 헤더는 파일이 없을 때만 한 번 씁니다.
- 2,000자에서 자르기 : 디스코드 메시지는 2,000자 제한이 있어요. 그런데 구글 뉴스 링크는 한 개가 200자를 넘습니다. 그래서
items[:10]처럼 건수로 자르면 10건도 제한을 넘겨요. 건수가 아니라 실제 글자 수로 잘라야 합니다. - res.raise_for_status() : 이게 없으면 알림 실패를 못 알아챕니다. 2,000자를 넘겨 400이 떨어져도 requests는 예외를 안 던지거든요. 저는 이것 때문에 "분명 돌았는데 디스코드엔 아무것도 안 옴"을 한참 헤맸어요 😇
- "flags": 4 : 링크마다 붙는 미리보기 카드를 끕니다. 안 끄면 기사 몇 개마다 똑같은 출처 카드가 주르륵 붙어서 채널이 지저분해져요.
- 웹훅 주소가 없으면 조용히 건너뜁니다 : 알림은 선택 기능이라 없다고 스크립트가 죽으면 안 되죠.
💬 디스코드 웹훅 만드는 법은 파이썬 업무 자동화 #4 - 디스코드 웹훅(Webhook)으로 알림 보내기 편에 캡처와 함께 정리해뒀어요!
📌 전체 코드 (복붙 OK)
# news_collector.py
# Python 3.10+ / feedparser 6.0.x / requests 2.34.x / beautifulsoup4 4.15.x
import calendar
import csv
import os
import re
import sqlite3
import time
from datetime import datetime, timezone, timedelta

import feedparser
import requests
from bs4 import BeautifulSoup
from dotenv import load_dotenv

load_dotenv()

KEYWORDS = [k.strip() for k in os.getenv("NEWS_KEYWORDS", "").split(",") if k.strip()]
WEBHOOK_URL = os.getenv("DISCORD_WEBHOOK_URL")

# 원하는 만큼 추가하세요. 이름은 자유롭게!
FEEDS = {
    "구글뉴스-파이썬": "https://news.google.com/rss/search?q=%ED%8C%8C%EC%9D%B4%EC%8D%AC&hl=ko&gl=KR&ceid=KR:ko",
    "구글뉴스-AI": "https://news.google.com/rss/search?q=AI&hl=ko&gl=KR&ceid=KR:ko",
}

DB_PATH = "news.db"
CSV_PATH = "news.csv"
KST = timezone(timedelta(hours=9))
HEADERS = {"User-Agent": "Mojangcam-NewsBot/1.0 (+https://mojangcam.tistory.com)"}

def init_db():
    conn = sqlite3.connect(DB_PATH)
    conn.execute("""
        CREATE TABLE IF NOT EXISTS seen (
            link       TEXT PRIMARY KEY,
            title      TEXT NOT NULL,
            source     TEXT,
            published  TEXT,
            collected  TEXT NOT NULL
        )
    """)
    conn.commit()
    return conn

def clean(html_text: str) -> str:
    if not html_text:
        return ""
    text = BeautifulSoup(html_text, "lxml").get_text(" ", strip=True)
    return re.sub(r"\s+", " ", text).strip()

def to_kst(entry) -> str:
    t = entry.get("published_parsed") or entry.get("updated_parsed")
    if not t:
        return ""
    dt = datetime.fromtimestamp(calendar.timegm(t), tz=timezone.utc)
    return dt.astimezone(KST).strftime("%Y-%m-%d %H:%M")

def match_keyword(title: str, summary: str) -> bool:
    if not KEYWORDS:
        return True
    blob = f"{title} {summary}".lower()
    return any(k.lower() in blob for k in KEYWORDS)

def fetch_feed(url: str):
    res = requests.get(url, headers=HEADERS, timeout=10)
    res.raise_for_status()
    return feedparser.parse(res.content)

def collect():
    conn = init_db()
    new_items = []

    for feed_name, url in FEEDS.items():
        try:
            parsed = fetch_feed(url)
        except requests.RequestException as e:
            print(f"[SKIP] {feed_name} 요청 실패: {e}")
            continue

        if parsed.bozo and not parsed.entries:
            print(f"[SKIP] {feed_name} 파싱 실패: {parsed.bozo_exception}")
            continue

        for entry in parsed.entries:
            link = entry.get("link", "").strip()
            title = clean(entry.get("title", ""))
            if not link or not title:
                continue

            summary = clean(entry.get("summary", ""))[:200]
            if not match_keyword(title, summary):
                continue

            cur = conn.execute("SELECT 1 FROM seen WHERE link = ?", (link,))
            if cur.fetchone():
                continue

            source = entry.get("source", {}).get("title") or feed_name
            published = to_kst(entry)
            collected = datetime.now(KST).strftime("%Y-%m-%d %H:%M")

            conn.execute(
                "INSERT INTO seen (link, title, source, published, collected)"
                " VALUES (?, ?, ?, ?, ?)",
                (link, title, source, published, collected),
            )
            new_items.append({
                "제목": title,
                "출처": source,
                "발행일": published,
                "링크": link,
                "요약": summary,
                "수집시각": collected,
            })

        time.sleep(1)  # 서버 배려! 피드 사이에 1초 쉬어요

    conn.commit()
    conn.close()
    return new_items

def save_csv(items):
    if not items:
        return
    is_new_file = not os.path.exists(CSV_PATH)
    with open(CSV_PATH, "a", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=list(items[0].keys()))
        if is_new_file:
            writer.writeheader()
        writer.writerows(items)

DISCORD_LIMIT = 2000

def notify_discord(items):
    if not WEBHOOK_URL or not items:
        return
    lines = [f"📰 **새 기사 {len(items)}건**"]
    for item in items:
        line = f"- [{item['제목']}]({item['링크']}) — {item['출처']}"
        # 2,000자를 넘기 직전에 멈춰요
        if len("\n".join(lines + [line])) > DISCORD_LIMIT - 40:
            lines.append(f"…외 {len(items) - (len(lines) - 1)}건")
            break
        lines.append(line)
    res = requests.post(
        WEBHOOK_URL,
        json={"content": "\n".join(lines), "flags": 4},  # flags=4 : 링크 미리보기 끄기
        timeout=10,
    )
    res.raise_for_status()   # 조용히 실패하지 않게!

def main():
    items = collect()
    print(f"[{datetime.now(KST):%Y-%m-%d %H:%M}] 새 기사 {len(items)}건")
    for item in items:
        print(f" - ({item['출처']}) {item['제목']}")
    save_csv(items)
    notify_discord(items)

if __name__ == "__main__":
    main()
📌 실행 결과
python news_collector.py[2026-08-20 08:09] 새 기사 2건
- (예제일보) 파이썬 3.15 정식 출시 임박 - lazy import 확정
- (예제경제) AI 반도체 수출 규제 논의바로 한 번 더 실행해보세요.
[2026-08-20 08:09] 새 기사 0건0건! 중복 제거가 제대로 돌고 있다는 뜻이에요 🙌 그리고 같은 폴더에 생긴 news.csv를 엑셀로 열면 이렇게 쌓여 있습니다.
| 제목 | 출처 | 발행일 | 링크 | 요약 | 수집시각 |
|---|---|---|---|---|---|
| 파이썬 3.15 정식 출시 임박 - lazy import 확정 | 예제일보 | 2026-08-19 09:30 | (기사 원문 주소) | 파이썬 3.15가 곧 나옵니다 | 2026-08-20 08:09 |
| AI 반도체 수출 규제 논의 | 예제경제 | 2026-08-19 11:05 | (기사 원문 주소) | 본문 요약입니다 | 2026-08-20 08:09 |
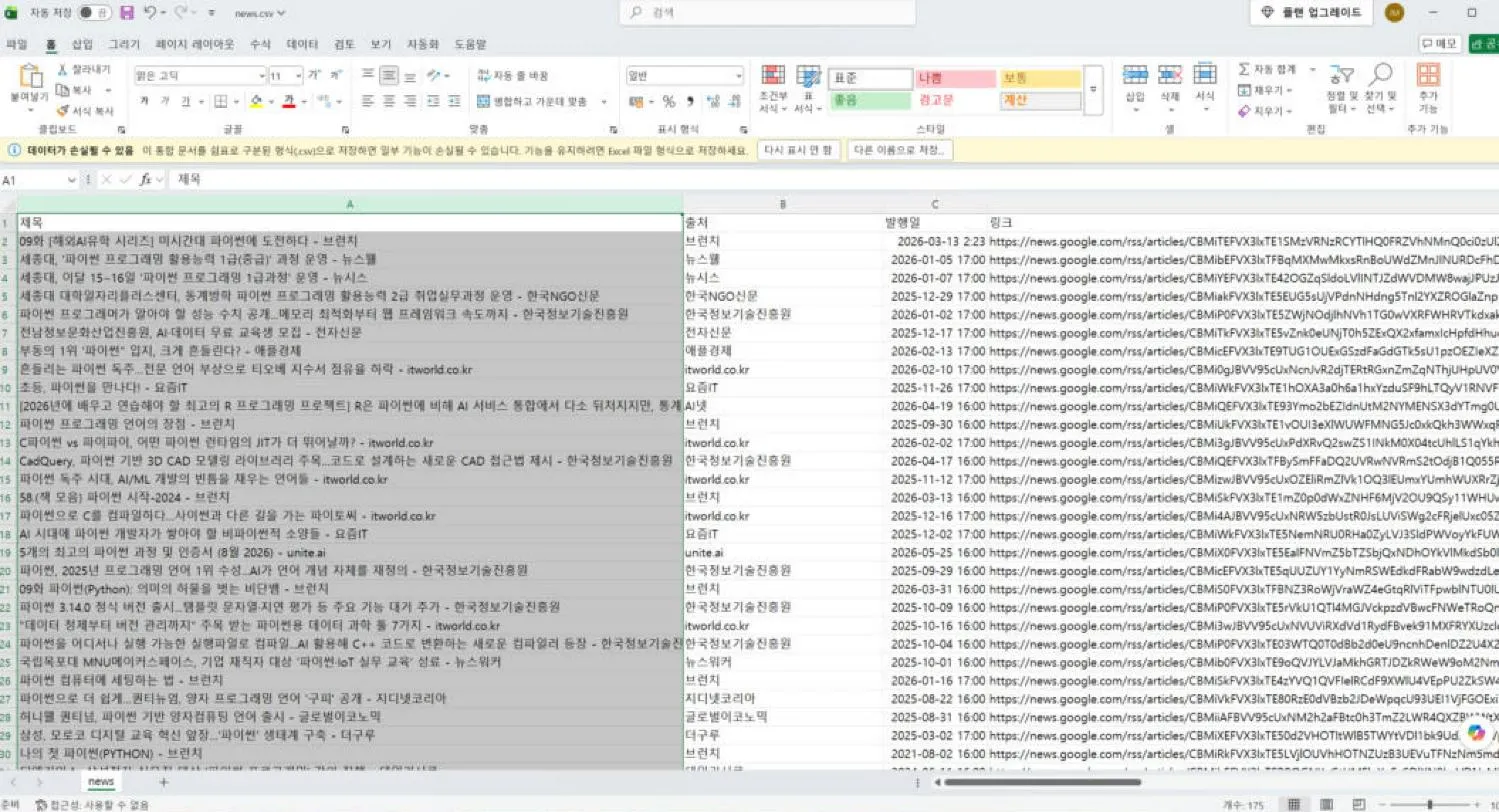
↑ 위 표는 설명용 예시고, 이 화면은 실제로 돌려서 나온 news.csv 입니다. 기사 200건이 그대로 쌓였고 한글도 안 깨졌어요.
💡 보너스 - 매일 아침 알아서 돌게 하기
스크립트를 손으로 실행하면 자동화가 아니죠 😅 파이썬 업무 자동화 #6 - 예약 실행 자동화 편에서 배운 걸 얹으면 끝나요.
import schedule

schedule.every().day.at("08:00").do(main)   # 매일 아침 8시
schedule.every(30).minutes.do(main)          # 또는 30분마다

while True:
    schedule.run_pending()
    time.sleep(1)
노트북을 24시간 켜두기 부담스럽다면 라즈베리파이로 24시간 돌리기 글도 같이 보시면 좋아요 🍓
⚠️ 크롤링 매너와 법 — 이건 꼭 읽어주세요
기술보다 이게 더 중요해요. 세 가지만 기억하시면 됩니다.
1. 기사 본문 전문을 복사해 저장·재배포하면 저작권 침해입니다. 뉴스 기사는 언론사의 저작물이에요. 제목·요약 몇 줄·원문 링크까지가 안전선이고, 본문을 통째로 긁어 내 블로그나 서비스에 올리는 순간 문제가 됩니다. 개인이 읽으려고 모으는 것과 재배포는 완전히 다른 이야기예요.
2. robots.txt를 먼저 확인하세요. 파이썬 내장 모듈로 3줄이면 됩니다.
from urllib.robotparser import RobotFileParser

rp = RobotFileParser()
rp.set_url("https://example.com/robots.txt")
rp.read()

print(rp.can_fetch("Mojangcam-NewsBot/1.0", "https://example.com/news/1"))  # True
print(rp.can_fetch("Mojangcam-NewsBot/1.0", "https://example.com/admin/x"))  # False
3. 서버를 괴롭히지 마세요. 요청 사이에 time.sleep(1) 정도는 반드시 넣고, 30분마다면 충분한 걸 1초마다 돌리지 마세요. 사이트 이용약관에 크롤링 금지 조항이 있다면 그것도 따라야 하고요. 매너 있는 봇은 오래 살아남습니다 🙂
📌 자주 나는 에러
1. 403 Client Error: Forbidden
- 원인: 기본 User-Agent(
python-requests/2.x)를 보고 봇으로 판단해 차단 - 해결: 위 코드처럼
HEADERS에 식별 가능한 User-Agent를 넣으세요. 그래도 막히면 그 사이트는 크롤링을 원치 않는 겁니다. RSS 피드를 찾아 쓰세요.
2. 한글이 안녕 처럼 깨져요
- 원인:
feedparser.parse(res.text)처럼 문자열을 넘겼거나, CSV를utf-8로 저장했을 때 - 해결: 피드는
res.content(바이트)를 넘기고, CSV는encoding="utf-8-sig"로 저장하세요.
3. 발행 시각이 9시간 어긋나요
- 원인:
time.mktime(entry.published_parsed)사용.mktime()은 값을 로컬 시간대로 해석해요. - 해결:
calendar.timegm()으로 바꾸세요.published_parsed는 항상 UTC 기준입니다.
4. entries가 0건이에요 (에러는 안 나는데)
- 원인: RSS가 아닌 일반 HTML 주소를 넣었거나, 피드 주소가 바뀐 경우
- 해결:
print(parsed.bozo, parsed.bozo_exception)을 찍어보세요.bozo가 1이면 XML 파싱에 문제가 있다는 신호예요. 브라우저로 그 주소를 열어<rss>또는<feed>태그로 시작하는지 확인하세요.
5. CSV가 한 줄씩 띄워져서 저장돼요 (윈도우)
- 원인:
open()에newline=""를 빠뜨림 - 해결:
open(path, "a", newline="", encoding="utf-8-sig")— 이 조합을 통째로 외워두세요!
6. 스크립트는 잘 돌았는데 디스코드에 알림이 안 와요
- 원인: 메시지가 2,000자를 넘어서 디스코드가 400으로 거절했는데,
requests.post는 예외를 안 던져서 그냥 넘어간 경우예요. 구글 뉴스처럼 링크가 긴 피드는 10건만 넣어도 넘칩니다. - 해결: 건수가 아니라 글자 수로 자르고,
res.raise_for_status()를 꼭 붙이세요. 실패를 소리 나게 만들어야 고칠 수 있어요.
📌 마무리
오늘은 입문 편의 크롤링을 실전 수집기로 끌어올렸어요. 정리하면요 📝
- 뉴스는 HTML이 아니라 RSS로 — 안 막히고, 안 깨지고, 저작권도 안전
feedparser+requests로 받고,res.content를 넘겨서 인코딩 사고 방지- 발행 시각은
calendar.timegm()(mktime아님!) - 링크를 PRIMARY KEY로 잡은 SQLite 한 장으로 중복 완전 차단
- CSV는
utf-8-sig+newline="", 웹훅 주소는.env로 - 그리고
robots.txt와 저작권 — 기술보다 중요한 부분 ⚠️
여기에 키워드만 본인 업계로 바꾸면 바로 쓰는 도구가 됩니다. 경쟁사 이름, 관심 종목, 채용 공고, 좋아하는 게임 업데이트 소식까지 뭐든지요!
다음 편에서는 RSS가 아예 없는 사이트를 다뤄볼게요. 로그인이 필요하거나 스크롤해야 내용이 나오는 동적 페이지를 Selenium으로 여는 이야기예요. 기대해주세요 🙌
📚 함께 보면 좋은 글
- 파이썬 업무 자동화 #2 - 웹 크롤링 입문 (requests + BeautifulSoup) — 오늘 글의 기초편
- 파이썬 정규표현식(re) 입문 — 텍스트 정리의 기본기
- 파이썬 업무 자동화 #4 - 디스코드 웹훅으로 알림 보내기 — 알림 붙이기
- 파이썬 업무 자동화 #6 - 예약 실행 자동화 (schedule·APScheduler) — 매일 자동 실행
- 디스코드 봇 만들기 #23 - aiosqlite로 비동기 DB 제대로 설계하기 — JSON 대신 DB를 쓰는 이유
